Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Dateningenieur
Halten langsame Abfragen, manuelle CSV-Exporte oder defekte Datenpipelines dein Business auf?
Ich bin ein professioneller Data Engineer, spezialisiert auf den Aufbau robuster, automatisierter ETL/ELT-Pipelines und moderner Cloud-Architekturen mit Python, SQL, dbt und Dagster.
Meine Leistungen:
Automatisierte Ingestion: Daten aus REST-APIs, Webhooks oder Drittanbieterplattformen direkt in dein Warehouse mit Python und dlt extrahieren.
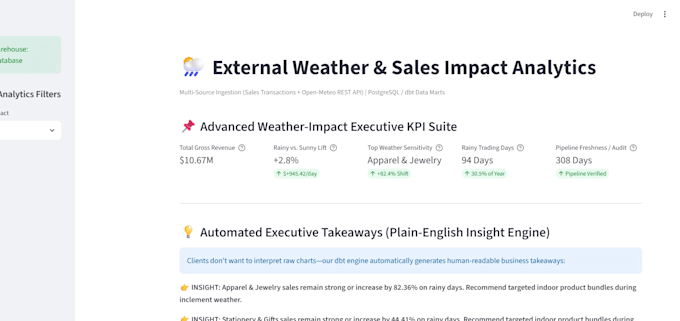
Transformations & Modellierung: Modulare dimensionale Data Marts mit dbt Core erstellen, um saubere, verifizierte Tabellen für BI-Reporting zu gewährleisten.
Warehouses & Datenbanken: Einrichtung, Schema-Design und Query-Optimierung für PostgreSQL, ClickHouse, Snowflake und DuckDB.
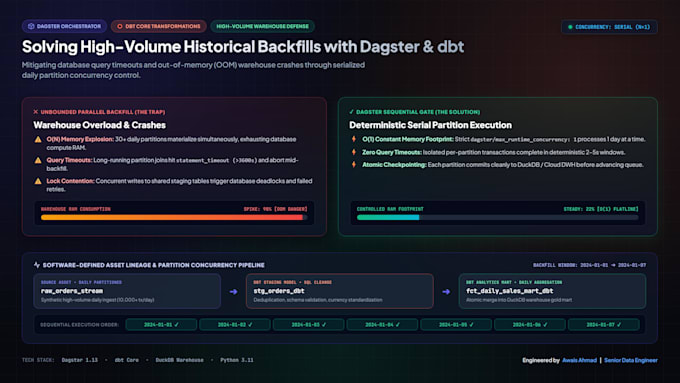
Workflow-Orchestrierung: Datenworkflows mit Dagster oder Airflow planen, überwachen und automatisieren, um OOM-Abstürze und Timeouts zu vermeiden.
Reverse-ETL: Transformierte Analysen zurück in dein CRM synchronisieren (z.B. Salesforce, HubSpot).
Warum du mich wählen solltest?
Sauberer, wartbarer, produktionsreifer Code mit Dokumentation.
Schnelle Kommunikation und Support nach der Lieferung.
Bitte schick mir eine Nachricht mit deinen Projektanforderungen, bevor du eine Bestellung aufgibst!

Automatische Übersetzung
Was muss ich für den Einstieg bereitstellen?
Zugriff oder API-Schlüssel zu deinen Datenquellen, Datenbank-Zugangsdaten und eine kurze Beschreibung deiner erwarteten Ausgabe oder Ziel-Schema.
Welche Cloud-Plattformen und Datenbanken unterstützt du?
Ich spezialisiere mich auf PostgreSQL, ClickHouse, Snowflake, DuckDB, Python, dbt Core, Dagster und Docker-Containerisierung.
Kannst du meinen bestehenden Pipeline debuggen oder optimieren?
Ja! Wenn du langsame Abfrageleistung, Statement-Timeouts oder wiederkehrende Pipeline-Fehler hast, kann ich die Ursachen prüfen und beheben.