Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden

Automatische Übersetzung
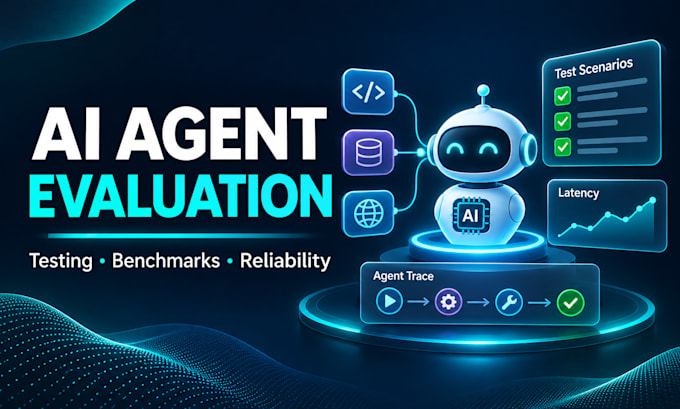
Produziert dein KI-Agent zuverlässige Ergebnisse oder scheitert er bei realweltlichen Aufgaben?
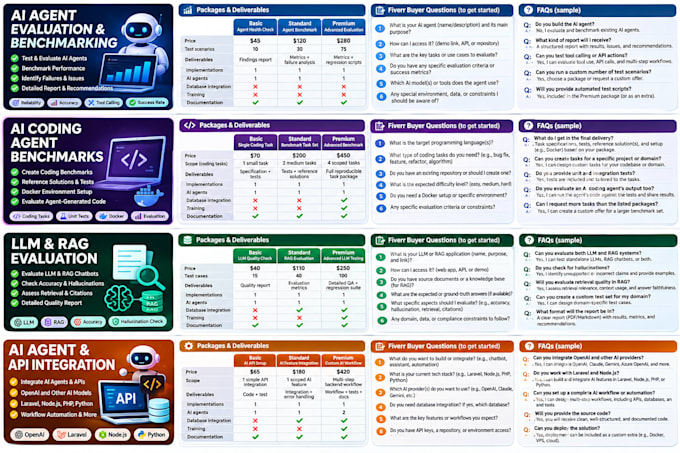
Ich teste, bewerte und benchmarke deinen KI-Agenten mit strukturierten Testfällen und Leistungsanalysen, um Schwachstellen zu identifizieren und die Zuverlässigkeit zu erhöhen.
Was ich bewerten kann:
Was du bekommst:
Ich bringe eine Software-Engineering-Hintergrund mit praktischer Erfahrung in AI-Coding-Evaluierung, Benchmark-Übungen, Python, Docker und automatisiertem Testen.
Kontaktiere mich vor der Bestellung, um dein Agent, deine Evaluationsumgebung und deine Testanforderungen zu besprechen.
Software Engineer, AI Coding Evaluation, Agent Benchmarking
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Studiere ich KI-Agenten oder bewerte ich sie nur?
Dieser Gig fokussiert sich auf das Testen und Benchmarken vorhandener KI-Agenten. Entwicklung, Bereitstellung und größere Fehlerbehebungen sind nicht enthalten. Für Implementierungsarbeiten sieh dir bitte meinen AI Integration-Gig an.
Welche Leistungskennzahlen bewertest du?
Je nach Projekt kann ich die Erfolgsquote bei Aufgaben, Genauigkeit der Tools-Ausführung, Befolgung von Anweisungen, Fehlermuster, Latenz und Zuverlässigkeit bewerten.
Was bekomme ich nach der Evaluierung?
Basic enthält einen Befundbericht, Standard enthält Kennzahlen und Fehlanalyse, und Premium enthält Kennzahlen, Fehlanalyse und Regressionstests.
Kannst du Agenten testen, die mit verschiedenen Frameworks entwickelt wurden?
Ja, vorausgesetzt, der Agent bietet eine zugängliche Testoberfläche und seine Umgebung ist mit dem vereinbarten Umfang kompatibel.
Brauche ich Zugriff auf meinen Quellcode?
Nicht immer. Viele Evaluierungen können über eine API oder eine Testoberfläche durchgeführt werden. Codezugriff kann bei fortgeschrittenem Debugging oder Trace-Analyse nützlich sein.
Bleibt meine Projektinformation vertraulich?
Ich behandle dein Projektsmaterial vertraulich, verwende es nur für die vereinbarte Arbeit und halte mich an deine festgelegten Zugangs- und Datenbehandlungsanforderungen.