Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD

Automatische Übersetzung
Ich trainiere maßgeschneiderte LoRA-Modelle, die zuverlässig eine bestimmte Figur, ein Produkt oder einen Stil nachbilden, und erstelle ComfyUI-Workflows, die daraus konsistente Bilder und Videos machen.
Der vollständige Prozess: Datensatz, Beschriftung, Training und Regularisierung, damit das Modell genau bleibt und nicht in unrelated Generierungen ausartet.
Kein Datensatz? Ich erstelle einen aus deinen Rohfotos oder Videos oder generiere einen originalen synthetischen Satz für neue Figuren und Stile.
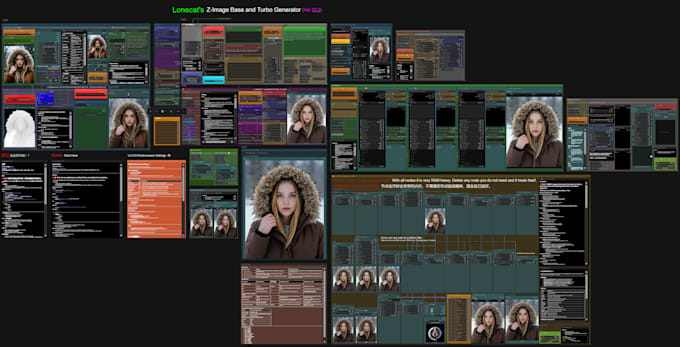
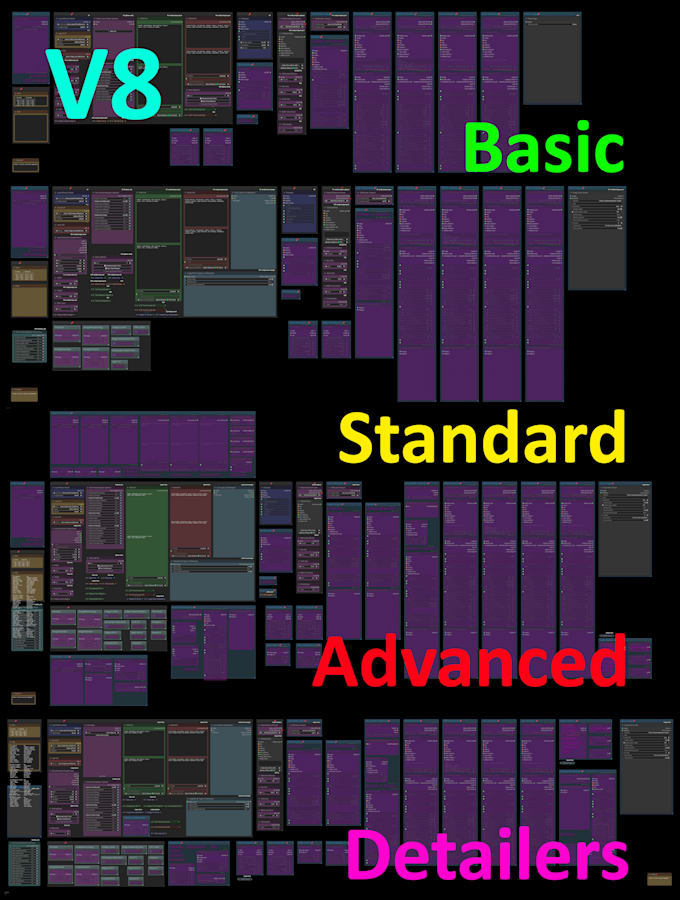
Workflows, die um dein LoRA gebaut sind:
- img2img: Bilder umgestalten und bearbeiten
- img2vid: deine Figur oder dein Produkt animieren
- ref2vid: Video aus deinen Referenzbildern
- Erste/letzte Frame zu Video: Aufnahmen zwischen zwei Keyframes
- Alles andere: Beschreibe die Aufgabe, ich sage dir, ob es machbar ist
Modelle: SDXL und FLUX.2 [klein] 4B, beide erlauben kommerzielle Nutzung. Nur Bilder, an denen du Rechte hast; echte Personen nur mit deren Zustimmung.
Jedes LoRA wird auf neuen Szenen und Prompts getestet, nicht nur auf den Trainingsfotos.
Premium: der Workflow plus ein Ein-Klick-Installationsskript. Wenn etwas kaputt geht, leite ich dich per Call durch die Einrichtung (Windows + NVIDIA).
Sende deine Referenzen und Ziele, und ich sage dir ehrlich, was realistisch ist, bevor du bestellst.
Bitte informiere den Freelancer über alle Präferenzen oder Bedenken in Bezug auf den Einsatz von KI-Tools bei der Ausführung und/oder Lieferung deines Auftrags.
Generative AI Specialist, ComfyUI and LoRA Training
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Welche Bilder muss ich bereitstellen?
Für eine Person, Figur oder ein Objekt – mindestens 15-20 klare, hochauflösende Fotos aus verschiedenen Blickwinkeln, mit unterschiedlicher Beleuchtung und Hintergründen. Für einen Stil – etwa 30-50 Beispielbilder. Mehr Vielfalt in deinen Fotos sorgt für ein flexibleres, zuverlässigeres LoRA.
Auf welcher Plattform kann ich das LoRA verwenden?
Du erhältst eine standardmäßige .safetensors-Datei, die in ComfyUI, Automatic1111 und den meisten anderen Stable Diffusion / FLUX-Tools funktioniert. Wenn du Hilfe bei der Einrichtung brauchst, enthält das Premium-Paket einen einsatzbereiten ComfyUI-Workflow.
Wie lange dauert das Training eigentlich?
Das Training selbst dauert in der Regel 1-3 Stunden, abhängig vom Modell. Der Großteil der Lieferzeit geht in Dataset-Vorbereitung, Beschriftung und das Generieren sauberer Mustergebnisse – nicht in den Trainingslauf selbst.
Wird das LoRA in Szenen funktionieren, die sich von meinen Trainingsfotos unterscheiden?
Ja, genau das ist das Ziel. Ich teste jedes LoRA mit Prompts, die neue Umgebungen, Beleuchtungen und Aktionen beschreiben, die in deinen Trainingsfotos nicht enthalten sind, um sicherzustellen, dass es generalisiert und nicht nur die Trainingsbilder wiederholt.
Kann ich das LoRA kommerziell nutzen?
Ja. Ich trainiere auf Apache 2.0 lizenzierten Basismodellen (SDXL, FLUX.2 Klein), sodass es keine Einschränkungen bei der kommerziellen Nutzung deiner generierten Ergebnisse gibt.
Was, wenn das erste Ergebnis nicht meinen Erwartungen entspricht?
Dafür sind Revisionen da – in jedem Paket enthalten. Gib mir konkretes Feedback (was nicht stimmt, welches Muster) und ich retrainiere oder passe es entsprechend an.