Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Dateningenieur
Steckt deine Daten in APIs, Dateien und Datenbanken fest und es gibt keinen zuverlässigen Weg, sie nach Azure für Berichte zu bringen?
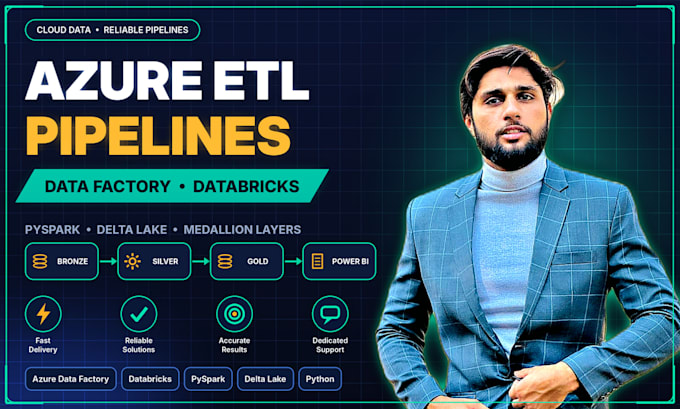
Ich erstelle automatisierte ETL-Pipelines in Azure Data Factory und Databricks, die deine Daten aufnehmen, mit PySpark bereinigen und analytics-ready Tabellen für Power BI liefern – on a schedule und ganz ohne manuellen Aufwand.
WAS ICH BAUE
Azure Data Factory-Pipelines: REST-APIs, Dateien und Datenbanken in Azure Data Lake
Databricks-Notebooks in PySpark und Spark SQL
Delta Lake-Tabellen mit Bronze / Silver / Gold (medallion) Layern
Star-Schema-Modelle und inkrementelle Läufe, ohne vollständige Re-Loads
Trigger, Scheduling, Logging und Data-Quality-Checks
Power BI-ready Outputs und klare Dokumentation
QUELLEN
REST-APIs, CSV/Excel/JSON, SQL-Datenbanken, Azure Blob- und Data Lake-Speicher
GEEIGNET FÜR
Startups und kleine Teams, die zu Azure wechseln und eine saubere, funktionsfähige Datenlayer benötigen.
WARUM ICH
Ich habe diesen Stack genau so am Stück aufgebaut – während eines Data-Engineering-Praktikums: API-Ingestion, eine Delta Lake Star-Schema-Architektur, die 20+ Städte abdeckt, und Power BI-Dashboards darüber.
Schreibe mir zuerst mit deinen Quellen, Datenmamm, und Ziel, dann bestätige ich Umfang und einen Festpreis.
Tools und Plattformen:
Airbyte
•
Kafka Connect
•
Azure Data Factory
Automatische Übersetzung
Wer bezahlt die Azure-Ressourcen?
Du, über dein eigenes Azure-Abonnement. Ich gestalte die Pipeline so, dass die Kosten niedrig bleiben, und sage dir vor dem Start den zu erwartenden Verbrauch.
Welchen Zugang benötigen Sie?
Eine Resource Group oder ein Workspace, in dem ich Data Factory- und Databricks-Objekte erstellen kann, plus Lesezugriff auf deine Quellen. Nie benötige ich Zugriff auf etwas Nicht-Relevantes.
Welche Quellen kannst du verbinden?
REST-APIs, CSV/Excel/JSON-Dateien, SQL-Datenbanken und Azure Blob- oder Data Lake-Speicher. Sag mir deine Quelle und ich bestätige, dass es möglich ist.
Kann ich das später selbst laufen lassen?
Ja. Es kommt mit Dokumentation, und das Premium-Paket enthält ein Übergabe-Meeting, damit dein Team es verwenden und erweitern kann.
Arbeitest du mit Fabric oder Snowflake?
In diesem Gig nicht. Schreib mir zuerst, dann sage ich ehrlich, ob es passt.
Läuft das automatisch?
Ja. Ich richte Data Factory-Triggers nach deinem Zeitplan ein, mit Logging, damit Fehler sichtbar sind.