Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
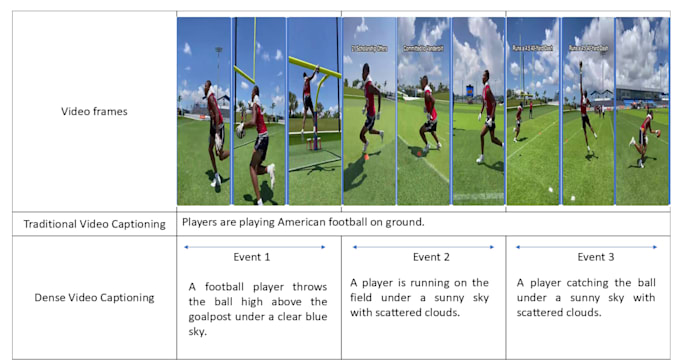
Vision-Language-Modelle sind nur so gut wie die Beschreibungen, von denen sie lernen. Wir schreiben detaillierte, genaue, menschlich verfasste Beschreibungen für jeden Moment deines Videos.
DIENSTLEISTUNGEN
- Zeitstempelbasierte Beschreibungen, die erklären, was passiert und wann
- Objekte, Positionen und Handlungen klar beschrieben
- Kurze oder ausführliche Stile, passend zu deinem Modell
- Auf Wunsch Frage-Antwort-Paare zum Video
LIEFERUMFANG
- Beschreibungsdatei pro Video im JSON-, CSV- oder SRT-Format
- Verwendeter Style-Guide, damit zukünftige Beschreibungen konsistent bleiben
- Zusammenfassung der Wort- und Beschreibungsanzahl
- Zweite-Person-Review bei jeder Beschreibung
WARUM MIT UNS ARBEITEN
- Von Menschen geschrieben, nicht automatisch generiert
- Genau und spezifisch, kein vages Füllmaterial wie "eine Person macht etwas"
- Konsistente Wortwahl im gesamten Dataset
- Revisionen inklusive
KOSTENLOSE MUSTER
Sende einen 1-Minuten-Clip und wir erstellen die Beschriftung kostenlos.

Technik:
Anleitung
Tagging-Typ:
Video
Automatische Übersetzung
Verwendest du KI, um Captions zu schreiben?
Menschen verfassen jede Beschriftung. KI kann Entwürfe vorschlagen, aber jede wird von einer Person geprüft und neu geschrieben.
Kannst du unsere Beschreibungsbeispiele anpassen?
Ja. Schick Beispiele und wir folgen genau dem Stil.
Kannst du auch Frage-Antwort-Paare erstellen?
Ja, auf Anfrage.