Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden

Automatische Übersetzung
Senke deine Modellauslatung und erhöhe den Durchsatz – mit messbaren Zahlen.
Typische Arbeiten:
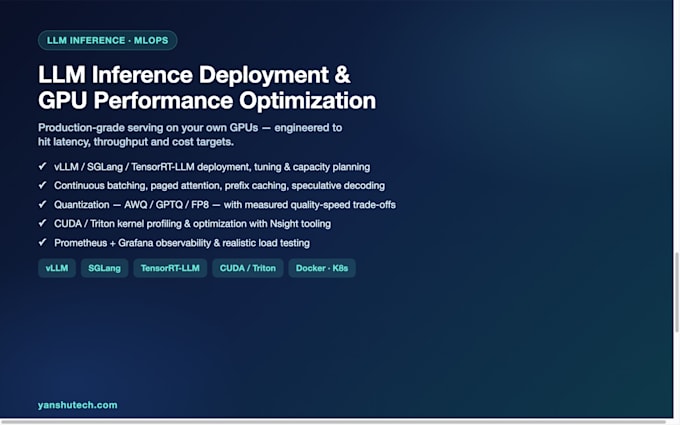
- Dein Modell mit vLLM, SGLang oder TensorRT-LLM betreiben, abgestimmt auf deine GPU-Flotte
- Kontinuierliches Batchen, paginierte Aufmerksamkeitsverarbeitung, Prefix-Caching, spekulatives Decoding
- Quantisierung (AWQ / GPTQ / FP8) mit einem Qualiät-vs-Geschwindigkeit-Vergleich, den du überprüfen kannst
- CUDA / Triton Profiling mit Nsight, um echte Engpässe zu finden
- Docker- / Kubernetes-Verpackung, Prometheus- und Grafana-Dashboards, realistische Lasttests
Was du bekommst: Serving-Configs, Benchmark-Ergebnisse (p50/p95-Latenz, Tokens/sec, Kosten pro 1 Mio Tokens), ein Lasttestbericht und ein kurzes Runbook, das dein Team betreiben kann.
Was NICHT enthalten ist: GPU-Hardware und Cloud-Ausgaben, Modell-Lizenzierung, bezahlte Drittanbieterdienste, 24/7-Notdienst. Alles läuft auf deiner Infrastruktur.
17 Jahre System- und ML-Engineering; Ich setze Modelle auf Kunden-GPUs im Rahmen meiner täglichen Produktentwicklung ein.
Sende mir vor der Bestellung Größe deines Modells, GPU-Typ und Zielwerte.
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Funktioniert das mit meiner GPU und meinem Modell?
Ja – A100, H100, L40S, RTX 4090 und jedes Hugging Face-Modell. Ich benchmarke zuerst auf deiner echten Hardware, bevor ich optimiere, damit du echte Zahlen für dein Setup bekommst.
