Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Full Stack Web Entwickler: WordPress, OCR, API-Integration, Peptid-Websites
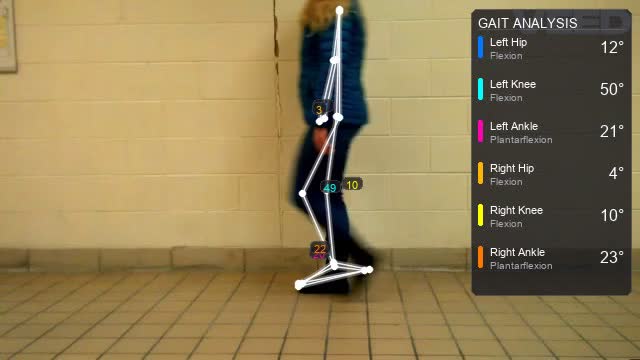
Musst du visuelles Tracking automatisieren, Daten extrahieren oder eine KI-App starten?
Manuelle Videoanalyse und Dokumentenbearbeitung kosten dein Business Zeit. Ich entwickle leistungsstarke KI-Computer Vision und OCR-Systeme, um deine Engpässe zu lösen und visuelle Daten in umsetzbare Erkenntnisse zu verwandeln.
Ob du eine eigenständige Computer Vision oder Objekterkennungs-App oder eine Datenextraktions-Pipeline brauchst, ich liefere robuste, einsatzbereite Software, die perfekt zu deinem Workflow passt.
PROBLEME, DIE ICH LÖSE:
TECH STACKS & TOOLS:
WARUM DIESEN SERVICE WÄHLEN?
Schreib mir vor der Bestellung, um dein Dataset zu besprechen!
Automatische Übersetzung
Was muss ich bereitstellen, um meine Computer Vision oder Objekterkennungs-App zu starten?
Bitte stelle dein Dataset bereit (Bilder, Videos oder Dokumentenscans) und eine klare Erklärung, welche Objekte oder Texte die KI-Computer Vision und OCR-System verfolgen oder extrahieren soll. Falls du noch keine Daten hast, helfe ich dir bei Datensammlung und individuellen Framework-Setups.
Welche Deep-Learning-Frameworks und Modelle nutzt du für die Entwicklung?
Ich schreibe hauptsächlich saubere Python KI-Skripte mit OpenCV für Echtzeit-Video-Feeds, zusammen mit PyTorch und TensorFlow für Model-Training. Für hohe Geschwindigkeit und Genauigkeit setze ich modernste Architekturen wie YOLOv8 und YOLOv11 ein, um erstklassige Ergebnisse zu gewährleisten.
Kann dein OCR-System handschriftlichen Text oder komplexe Dokumente verarbeiten?
Ja, das intelligente OCR-System ist mit robusten Engines (wie Tesseract, EasyOCR oder Cloud-Vision-APIs) konfiguriert, um Mehrspalten-Layouts, digitale Rechnungen und komplexe Textfelder zu lesen und Rohdateien in strukturierte, durchsuchbare Datenpipelines umzuwandeln.
Wird die fertige Anwendung lokal laufen oder in die Cloud deployt?
Beides! Je nach Bedarf liefere ich deine Lösung als leichtes Desktop-Tool, verpacke sie in Docker-Container für Cloud-Server (AWS/GCP) oder baue eine voll interaktive KI-Web-App mit modernen Python-Dashboard-Tools wie Streamlit.
Wie garantierst du die Genauigkeit beim Objekt-Tracking und bei der Bildsegmentierung?
Jede Pipeline durchläuft strenge Validierungstests mit individuellen Machine-Learning-Bewertungsmetriken. Ich justiere die Confidence-Thresholds, eliminiere False Positives und verfeinere die Bildsegmentierungs-Masken, bis das System deine geforderte Produktionsgenauigkeit erreicht.