Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Python, Data Engineering, APIs und AI Automation
Suchst du eine zuverlässige Datenpipeline, die echte Produktionsarbeitslasten bewältigen kann?
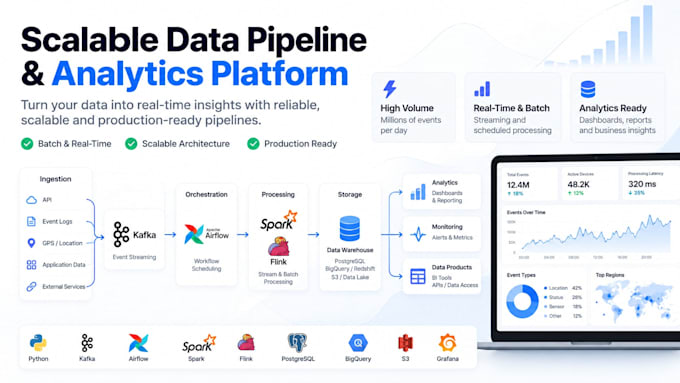
Ich baue skalierbare und wartbare Datenpipelines für Batch- oder Echtzeitverarbeitung mit Technologien wie Python, Airflow, Kafka, Spark, SQL, PostgreSQL, AWS und GCP
Ich kann dir bei folgendem helfen:
Ich habe über 10 Jahre Erfahrung in Softwareentwicklung in den Bereichen Backend, Data Engineering, Cloud und DevOps, inklusive Hochvolumen-Systemen, die große Datensätze und hunderte Tausende Events pro Tag verarbeiten.
Du erhältst sauberen, wartbaren Code, klare Dokumentation und eine Lösung, die auf deine tatsächlichen Anforderungen zugeschnitten ist.
Hast du eine komplexe Pipeline oder ein Produktionsproblem?
Schreib mir vor der Bestellung und ich helfe dir, die richtige Architektur und das passende Paket zu wählen.