Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD

Level 2
Automatische Übersetzung
AI SYNTHETISCHE DATEN & MODELLE BENCHMARKING
DAS PROBLEM
DIE LÖSUNG
Wir erstellen produktionsbereite synthetische Datensätze mit realistischen Edge Cases und automatisierten Evaluierungs-Pipelines, um Modellgenauigkeit, Latenz und Zuverlässigkeit zu testen.
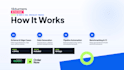
WAS WIR LIEFERN
WARUM TKTURNERS
Fachspezialisierte KI-Entwicklung mit Fokus auf hochwertige Datensätze, strukturierte Generierung und zuverlässige Modellbewertung.
SCHNELLER VERSAND
Erhalte validierte Datensätze und Benchmark-Pipelines, die bereit sind für Feinabstimmung oder Produktionsevaluation.
KOSTENLOSE DATENÜBERPRÜFUNG
Kontaktiere uns vor der Bestellung für eine kostenlose Datenstrategie- & Schema-Überprüfung.
Senior Software Engineer
Level 2
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Warum sollte ich Ihnen vor der Bestellung eine Nachricht senden?
Eine vorherige Kontaktaufnahme ermöglicht es uns, dein Daten-Schema, die Domänenanforderungen und die Evaluationsziele zu prüfen, um das passende Paket auszuwählen und Lieferverzögerungen zu vermeiden.
Was ist synthetische Trainingsdaten und wie werden sie verwendet?
Synthetische Trainingsdaten sind künstlich generierte Daten, die reale Verteilungen nachahmen. Sie ermöglichen Feinabstimmung und Tests von KI-Modellen ohne Datenschutzrisiken oder manuelle Kennzeichnungskosten.
Welche Datenformate unterstützt du?
Wir liefern Daten im JSONL-, CSV-, Parquet-, JSON- und Standard-Hugging Face-Dataset-Format, optimiert für Feinabstimmung von OpenAI, Anthropic oder Open-Source-Modellen.
Wie stellt ihr sicher, dass die synthetischen Daten von hoher Qualität sind?
Wir verwenden Schema-Beschränkungen, semantische Duplikat-Entfernung, statistische Verteilungsprüfungen und automatisierte Validierungsregeln, um Halluzinationen und Formatierungsfehler zu vermeiden.
Was ist im Modellbewertungsprozess enthalten?
Der Prozess umfasst automatisiertes Benchmark-Testing, Genauigkeitsbewertungen, Latenz-Tracking, LLM- als-Urteil-Bewertungen und Regressionstests-Berichte.
Sind API-Nutzungskosten und Kosten für Drittanbieter-Modelle enthalten?
Nein, API-Nutzungskosten (OpenAI, Anthropic oder Cloud-Compute) werden direkt auf dein Konto abgerechnet. Wir unterstützen bei Schlüsselkonfigurationen und Budgetoptimierung.
Welchen Zugang oder welche Informationen brauchst du, um zu starten?
Wir benötigen dein Zielschema, Beispiel-Daten (falls vorhanden), Geschäftsregeln und die Bewertungs- oder Metrik-Kriterien, die du benchmarken möchtest.
Wie bleibt meine proprietäre Geschäftsdaten privat?
Wir unterschreiben Standard-Non-Disclosure-Agreements, speichern deine sensiblen Eingaben niemals dauerhaft und generieren vollständig anonymisierte, datenschutzkonforme Datensätze.
Wie funktionieren Revisionen bei der Datensatz-Erstellung?
Revisionen umfassen Feinabstimmung der Datensatz-Verteilung, Anpassung von Edge Cases, Verfeinerung von Prompt-Vorlagen oder erneutes Ausführen spezifischer Bewertungsmetriken.
Bietest du laufende Pipeline-Wartung an?
Ja, wir bieten laufende Wartung und Erweiterung der Datensätze durch individuelle Meilensteine oder monatliche Support-Pakete an.


