Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD

Level 2


Automatische Übersetzung
CUSTOM LLM FEINABSTIMMUNG
Generische KI-Modelle können Halluzinationen verursachen oder bei deinen Geschäftsabläufen versagen. Feinabstimme sie mit deinen eigenen Daten, Formatierungen und Domänenwissen.
LIEFERUMFANG & SCHNELLIGKEIT
DIE LÖSUNG
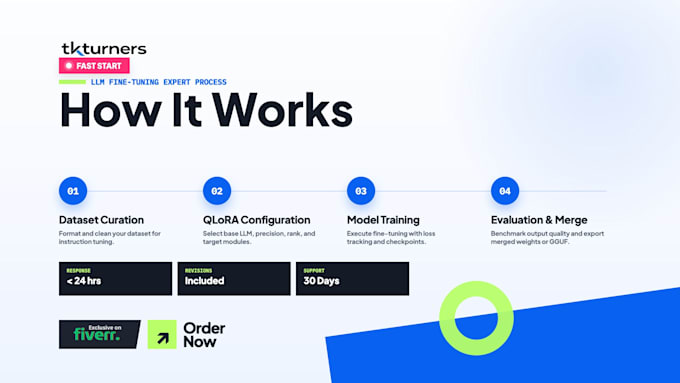
Wir erstellen saubere Instruktionsdatensätze, optimieren rank/alpha-Parameter und feinabstimmen Modelle für bessere Domänenleistung und niedrigere Inferenzkosten.
WARUM TKTURNERS
Full-Stack-KI-Ingenieure liefern produktionsbereite Modelle und Workflow-Automatisierung, maßgeschneidert auf deine Geschäftsbedürfnisse.
QUALITÄTSGARANTIE
Jedes Modell wird anhand vereinbarter Test-Prompts bewertet. Wenn die Ergebnisse die Zielmetriken verfehlen, retrainieren wir ohne zusätzliche Kosten.
KOSTENLOSE KI-PRÜFUNG
Schreibe uns vor der Bestellung für eine kostenlose 15-minütige Dataset-Prüfung & Modellarchitektur-Empfehlung.
Senior Software Engineer
Level 2
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Warum sollte ich Ihnen vor der Bestellung eine Nachricht senden?
Eine vorherige Kontaktaufnahme ermöglicht es uns, die Größe deines Datensatzes zu bewerten, die Kompatibilität des Basismodells (z.B. Llama 3, Mistral) zu überprüfen und die Rechenanforderungen zu bestätigen, damit du genau das richtige Paket erhältst.
Welche Basismodell-Architekturen unterstützt du für Feinabstimmung?
Wir unterstützen Llama 3/3.1, Mistral, Mixtral, Gemma 2, Qwen 2.5, DeepSeek, Falcon und jedes benutzerdefinierte Open-Weights-Modell, das auf Hugging Face gehostet wird.
Was ist der Unterschied zwischen LoRA und QLoRA?
LoRA trainiert Adapter-Matrizen niedriger Rang, um ein Modell effizient anzupassen. QLoRA quantisiert das Basismodell während des Trainings auf 4-Bit-Genauigkeit, was die GPU-VRAM-Anforderungen drastisch reduziert und gleichzeitig die Spitzenleistung des Modells beibehält.
Wer trägt die Kosten für GPU-Compute und Cloud-Infrastruktur?
Rechenkosten (RunPod, Lambda Labs, Google Colab Pro oder Hugging Face Inference Endpoints) werden direkt vom Kunden bezahlt. Wir beraten dich bei der kosteneffizientesten GPU-Konfiguration.
In welchem Format soll mein Datensatz bereitgestellt werden?
Du kannst deine Daten in JSON, JSONL, CSV oder Rohtext bereitstellen. Wir reinigen, validieren und konvertieren sie in Standard-Instruktionsformate wie Alpaca, ShareGPT oder ChatML.
Welche genauen Ergebnisse erhalte ich nach Abschluss des Projekts?
Du erhältst trainierte LoRA-Adaptergewichte, das zusammengeführte eigenständige Modell (falls gewünscht), GGUF-quantisierte Dateien für Ollama/LM Studio, Testskripte und Bewertungsmetriken.
Kannst du das feinabgestimmte Modell in eine API oder private Cloud deployen?
Ja. Wir können dein trainiertes Modell auf Hugging Face Dedicated Endpoints, RunPod serverless, vLLM, Ollama oder einem benutzerdefinierten FastAPI-Backend auf AWS/GCP deployen.
Welchen Drittanbieter-API- oder Plattformzugang benötigst du?
Wir benötigen möglicherweise Lese-/Schreibzugriff auf dein Hugging Face-Konto (Zugangstoken) und deine gewählte GPU-Cloud-Plattform (RunPod, Lambda Labs oder AWS) via API-Schlüssel oder temporäre Anmeldeinformationen.
Wie gehst du mit Revisionen und Benchmark-Performance um?
Jede Stufe beinhaltet Revisionen zur Feinabstimmung von Lernraten, Epochen oder rank/alpha-Parametern. Wir bewerten dein Modell anhand von Validierungs- und Testsets, um die Qualität zu sichern.
Bieten Sie Support und Wartung nach der Lieferung an?
Ja, wir bieten laufende Wartung und Retainer-Unterstützung für periodische Dataset-Ingestion, Modell- retraining und Cloud-Inferenzskalierung an.