Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Python-Automatisierung, Datenpipelines und Excel-Lösungen, Finanzhintergrund
Deine Daten kommen in Dateien, APIs und Exporten an, die nicht miteinander übereinstimmen, und jemand fügt sie jeden Monat manuell zusammen.
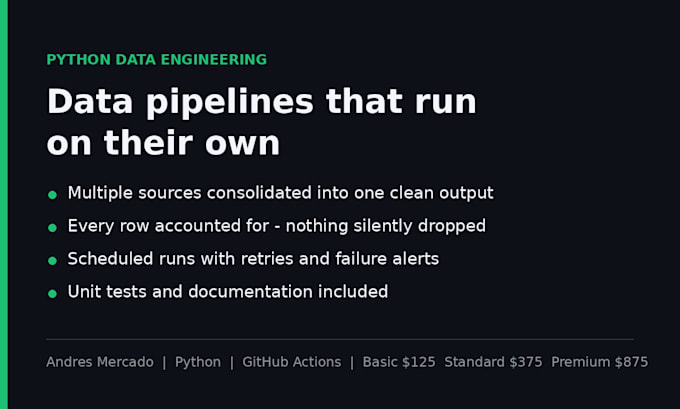
Ich baue das stattdessen als eine Pipeline: ein wiederholbarer Job, der deine Quellen einliest, sie auf ein einheitliches Schema normalisiert und das Ergebnis liefert, das du wirklich brauchst – nach einem festen Zeitplan, ohne dass jemand ständig dabei sein muss.
So arbeite ich:
Jede Quellzeile wird berücksichtigt. Zeilen, die nicht gemappt werden können, werden MARKIERT, niemals stillschweigend gelöscht. Du bekommst eine Abstimmung, die die Zählungen vor und nach zeigt.
Fehlerfälle werden zuerst behandelt: Wiederholungen bei temporären Fehlern und eine Benachrichtigung, wenn eine Quelle nicht verfügbar ist, anstatt einen leeren Bericht zu erzeugen.
Zugangsdaten liegen in Umgebungsgeheimnissen, die du kontrollierst, niemals im Code.
Tests sind inklusive, damit Änderungen im Format eines Anbieters erkannt werden, bevor sie drei Wochen später entdeckt werden.
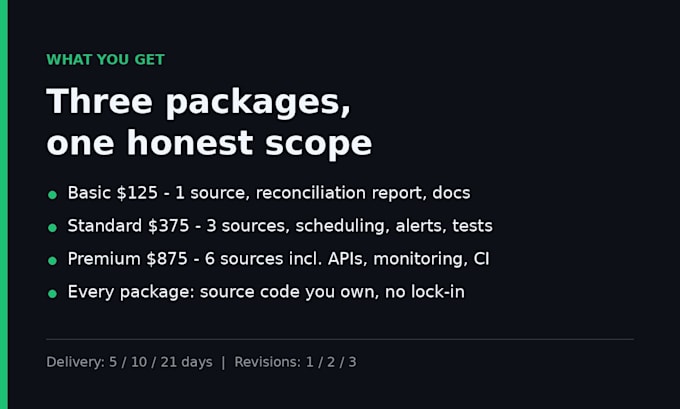
Ich baue diese mit CI, Typüberprüfung, automatischer Bereitstellung und geplanter Ausführung als Standard. Deine Lieferung umfasst den projektspezifischen Code, seine Tests und Dokumentation, entsprechend deinem Paketumfang.
Schreib mir mit deinen Quellen und was das Ergebnis aussehen soll, und ich sage dir ehrlich, ob das passt, bevor du bestellst.
Zielplattform:
Andere
Tools und Plattformen:
Andere
Automatische Übersetzung
Mit welchen Datenquellen können Sie arbeiten?
CSV, Excel, JSON, XML, SQL-Datenbanken (Postgres, MySQL, SQLite) und REST-APIs. Wenn deine Daten anders sind, schick mir zuerst eine Nachricht, und ich sage dir ehrlich, ob das passt.
Werde ich es später selbst ausführen können?
Ja. Du bekommst den Quellcode und die Setup-Dokumentation, und das Premium-Paket beinhaltet eine Übergabesession: einen geplanten Anruf von bis zu 45 Minuten. Wichtig ist, dass du nicht von mir abhängig bist.
Was passiert mit Zeilen, die nicht zum Schema passen?
Sie werden mit einem Grund markiert, niemals gelöscht. Stillschweigender Datenverlust ist der häufigste und schädlichste Fehler bei dieser Arbeit, deshalb rechne ich Counts vor und nach der Verarbeitung ab und zeige dir den Unterschied.
Brauchst du Zugriff auf unsere Produktionssysteme?
Nein, und das möchte ich auch nicht. Exporte oder ein Read-Only-Zugang reichen für fast alles aus.
Kann das automatisch nach Zeitplan laufen, ohne dass ich etwas mache?
Ja, ab dem Standard-Paket. Es läuft nach einem Zeitplan in deinem eigenen Account – meistens mit GitHub Actions, sodass du kein neues Abonnement kaufen musst. Ich erstelle und teste den geplanten Job und übergebe dir die Konfiguration sowie eine Anleitung zum Setup, damit nichts von mir abhängt.
Was, wenn sich das Format einer Quelle nach der Lieferung ändert?
Die Tests erkennen das. Innerhalb des Revision-Fensters werde ich es beheben; darüber hinaus mache ich gern ein Angebot für eine kleine Wartungsarbeit.