Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Senior Software Engineer POS, ERP und KI-basierte Web- und Mobile-Lösungen
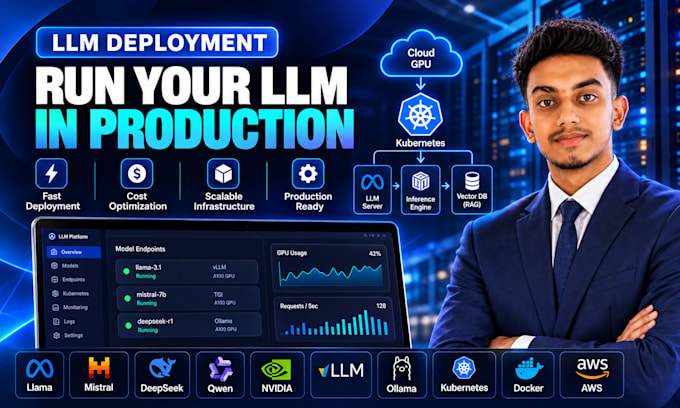
Möchtest du dein LLM schnell, optimiert und kosteneffizient in Produktion bringen?
Du bist hier genau richtig!
Ich deploye und konfiguriere Open-Source LLMs auf GPU-Cloud-Servern und Kubernetes, mit abgestimmten Inference-Engines für schnelle Antworten und niedrigere GPU-Kosten.
Was ich anbiete:
Technologie-Stack:
Inference: vLLM || TGI || Ollama || NVIDIA Triton || TensorRT-LLM || llama.cpp || SGLang
Modelle: Hugging Face || Llama || Mistral || Qwen || DeepSeek
Cloud & GPU: AWS || Google Cloud || Azure || RunPod || Lambda Labs
Container: Docker || Kubernetes || Helm
Monitoring: Prometheus || Grafana
Warum mich wählen?
Lass uns dein LLM noch heute live schalten!
Automatische Übersetzung
Welche LLMs kannst du bereitstellen?
Jedes Open-Source-Modell von Hugging Face, inklusive Llama, Mistral, Qwen, DeepSeek, Gemma und Phi, sowie feinabgestimmte oder individuelle Modelle, die du bereitstellst.
Was beinhaltet die Konfiguration des inference engine?
Einrichten und Abstimmen von vLLM, TGI, Triton oder Ollama für dein Modell: GPU-Speicher, Batching, Kontextlänge, KV-Cache, Tensor-Parallelismus und Quantisierung, damit du schnellere Antworten bei geringeren Kosten bekommst.
Welchen inference engine soll ich verwenden?
vLLM für APIs mit hohem Durchsatz, TGI für Hugging Face-Modelle, Triton oder TensorRT-LLM für maximale NVIDIA GPU-Leistung, und Ollama oder llama.cpp für kleinere oder CPU-basierte Setups. Ich empfehle die beste Lösung.
Kannst du meine GPU-Kosten senken?
Ja. Durch Quantisierung (AWQ, GPTQ, GGUF), Batching und passende GPU-Größen kann ich oft dasselbe Modell auf günstigerer Hardware mit ähnlicher Qualität laufen lassen.
Funktioniert die API wie die von OpenAI?
Ja. Ich kann eine OpenAI-kompatible API-Endpunkt einrichten, sodass du deine bestehende App einfach von OpenAI auf dein eigenes LLM umstellen kannst, indem du nur die Basis-URL und den API-Schlüssel änderst.
Wer trägt die Kosten für GPU und Cloud?
GPU- und Hostingkosten werden vom Anbieter (AWS, GCP, Azure, RunPod usw.) auf dein Konto abgerechnet. Ich helfe dir, die kosteneffizienteste GPU für dein Modell und Traffic zu wählen.
Sind mein Modell und meine Daten privat?
Ja. Dein LLM läuft auf deinen eigenen Servern, sodass Prompts und Daten niemals an Dritt-APIs gehen. Ich sichere den Endpunkt auch mit API-Schlüsseln, SSL und Firewall-Regeln. Bei Bedarf kann ich eine NDA unterschreiben.
Was muss ich bereitstellen, bevor wir beginnen?
Das gewünschte Modell (oder deine Anforderungen), Zugriff auf dein Cloud- oder GPU-Konto, erwarteter Traffic und eine Domain, die du verwenden möchtest. Wenn du unsicher bist, biete ich eine kostenlose Beratung an.
Kannst du ein Modell deployen, das ich feinabgestimmt habe?
Ja. Teile mir deine Modellgewichte oder dein Hugging Face-Repo mit, und ich deploye und optimiere es mit dem passenden inference engine.
Bist du unsicher, welches Paket zu deinem Projekt passt?
Schreib mir vor der Bestellung. Ich prüfe dein Modell und deine Traffic-Anforderungen und empfehle das passende Paket oder sende ein individuelles Angebot.
