Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
KI-Ingenieur: LLM-Feinabstimmung mit LoRA und QLoRA
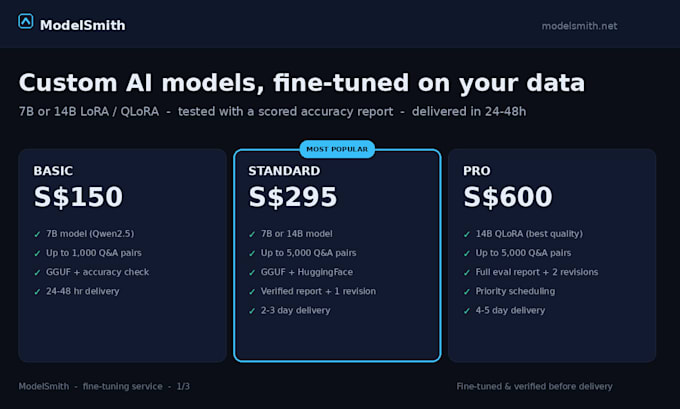
Ich feine 7B- und 14B-KI-Modelle auf deine Daten an. Nicht Prompt-Vorlagen – echte, feinabgestimmte LLMs, trainiert mit deinen Fragen und Antworten, vor Lieferung getestet und im Format geliefert, das du brauchst.
Was ich mache:
- LoRA / QLoRA-Feinabstimmung von 7B- oder 14B-Modellen (Qwen2.5 standardmäßig)
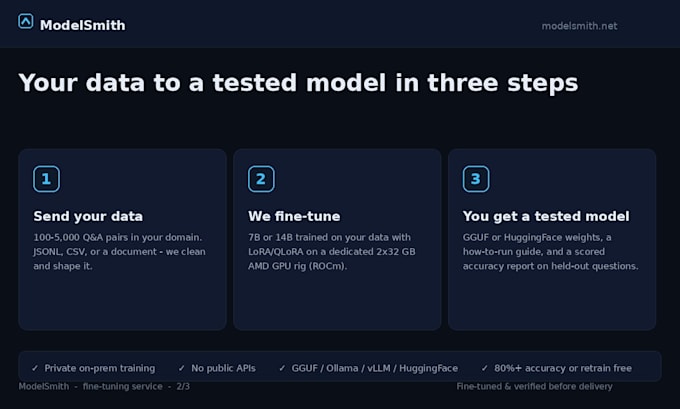
- Trainiert mit 100 bis 5.000 deiner eigenen Q&A-Paare
- Verifiziert mit einem Bewertungsbericht zur Genauigkeit bei gelesenen Fragen
- Geliefert als GGUF (Ollama, llama.cpp) oder HuggingFace (vLLM, Transformers)
Warum es anders ist:
Die meisten Feinabstimmungs-Gigs liefern dir nur eine Datei und sagen viel Glück. Ich teste es zuerst. Jedes Modell kommt mit einem Genauigkeitsbericht zu deinen eigenen Hold-out-Daten – 80 Prozent oder mehr, oder ich trainiere kostenlos neu.
Datenschutz:
Training läuft auf einem privaten 2x32 GB-GPU-Rig. Deine Daten gehen niemals an eine öffentliche API und werden bei Lieferung gelöscht, sofern du nicht willst, dass ich sie behalte.
Geschwindigkeit:
Eine 7B-LoRA trainiert in weniger als einer Stunde Rechenzeit. Die meisten Projekte liefern in 24 bis 48 Stunden.
Schick mir dein Dataset und ich habe in wenigen Tagen ein getestetes Modell bereit.


Programmiersprache:
Python
•
Pytorch
•
Andere
Datentyp:
Text
•
Tabellarische Daten
•
Andere
KI-Engine:
Llama
•
PyTorch
•
Andere
Automatische Übersetzung
Welches Modell verwendest du?
Qwen2.5-7B-Instruct standardmäßig für die 7B-Stufe. Qwen2.5-14B-Instruct für 14B. Mistral- und Llama-Modelle auf Anfrage verfügbar.
Was muss ich Ihnen schicken?
100 bis 5.000 Q&A-Paare in jedem Format: JSONL, CSV oder sogar als Dokument. Ich bereinige und strukturiere es.
Wodurch unterscheidet sich das von einer Prompt-Vorlage oder System-Prompt?
Eine Prompt-Vorlage instruiert ein generisches Modell. Eine Feinabstimmung ändert die Modellgewichte, sodass es deine Antworten direkt kennt. Bessere Genauigkeit, deine Stimme, geringerer Prompt-Overhead.
Sind meine Daten sicher?
Ja. Das Training läuft auf einem privaten lokalen 2x32 GB-GPU-Rig, nicht über eine öffentliche API. Das Dataset wird bei Lieferung gelöscht, falls du nicht willst, dass ich es behalte.
Was genau erhalte ich?
Model-Gewichte (GGUF und/oder HuggingFace), eine How-to-Run-Anleitung mit genauen Befehlen für deine Laufzeit (Ollama, llama.cpp, vLLM) sowie ein Bewertungsbericht.
Was, wenn das Modell nicht gut funktioniert?
Standard enthält 1 kostenlose Revision, Premium 2. Wenn die Hold-out-Bewertung dein Genauigkeitsziel verfehlt, trainiere ich kostenlos neu.
Wie lange dauert die Lieferung?
7B: 24–48 Stunden. 14B: 2–5 Tage. Die Bearbeitung beginnt, sobald dein Dataset bestätigt ist.
Brauche ich eigene GPU oder Hardware?
Nein. Ich führe alle Trainings auf meinem Rig durch. Du brauchst nur Hardware, um das finale Modell laufen zu lassen (jeder CPU kann ein 7B GGUF laufen, oder nutze Ollama).