Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Dateningenieur
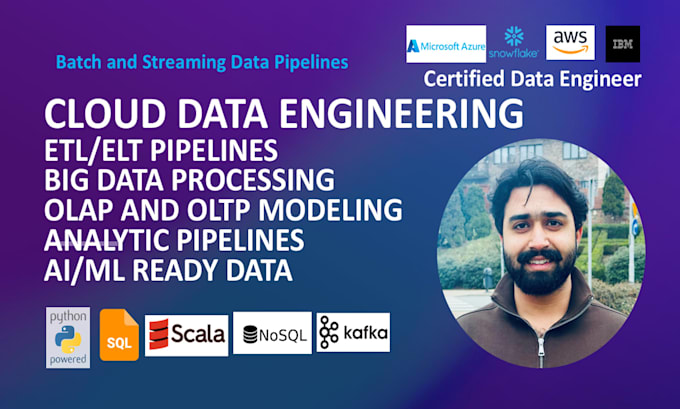
Suchst du einen Senior Data Engineer für skalierbare ETL/ELT-Pipelines, Big Data Verarbeitung, Data Warehousing oder Lakehouse-Architekturen?
Ich bin Muhammad Ahmed, ein Data Engineer mit über 4 Jahren Erfahrung im Aufbau von unternehmensweiten Datenplattformen in AWS, Azure, GCP und Snowflake-Ökosystemen.
Meine Dienstleistungen umfassen:
Technologien:
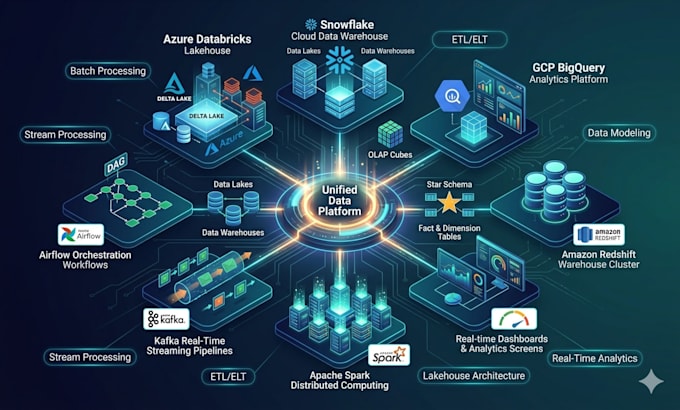
Azure Databricks, Snowflake, GCP BigQuery, Amazon Redshift, Apache Spark, PySpark, Kafka, Airflow, DBT, Snowflake SQL, SparkDF, PostgreSQL, AWS, Docker, Python, SQL.
Ich entwickle skalierbare, zuverlässige und cloud-native Data Engineering-Lösungen für Analytics, Reporting, Automatisierung und Echtzeitverarbeitung. Außerdem stelle ich AI/ML- und Analytics-ready Daten bereit.
Data Engineering, ETL, ELT, Big Data, PySpark, Airflow, Kafka, Snowflake, Databricks, Data Warehouse, Redshift, BigQuery.
Warehouse-Plattform:
Snowflake
•
BigQuery
•
Databricks
Projektart:
New Build
Automatische Übersetzung
Welche Cloud-Plattformen unterstützen Sie?
Ich arbeite mit AWS, Azure, GCP, Snowflake, Databricks, Amazon Redshift und BigQuery.
Baust du Batch- und Streaming-Pipelines?
Ja. Ich entwickle Batch-Pipelines mit Apache Spark und Streaming-Lösungen mit Kafka und Spark Streaming.
Kannst du Data Warehouse- und Lakehouse-Architekturen entwerfen?
Ja. Ich entwerfe skalierbare Data Lakes, Data Warehouses und Lakehouse-Systeme mit Medallion Architecture und modernen Cloud-Plattformen.
Welche Orchestrierungstools verwendest du?
Apache Airflow, Snowflake Tasks / geplante Jobs und cloud-native Scheduling-Lösungen.
Implementierst du Datenmodellierung?
Ja. Ich arbeite mit Star Schema, Snowflake Schema, Dimensions, Fact Tables, OLAP und OLTP Modellierung.
Welche Technologien nutzt du für die Datenverarbeitung?
PySpark, Spark SQL, DBT, Snowflake SQL, SparkDF, Python, SQL, Kafka und cloud-native Verarbeitungstools.
Kannst du bestehende Pipelines optimieren?
Ja. Ich kann die Leistung, Skalierbarkeit, Kostenoptimierung und Zuverlässigkeit bestehender Data Engineering-Systeme verbessern.