Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Automatische Übersetzung
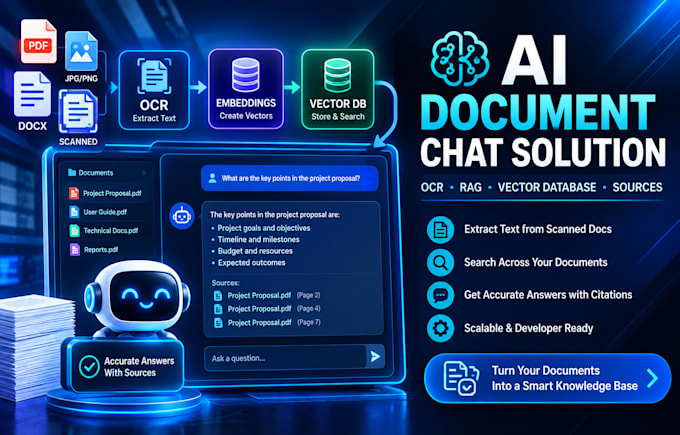
Suchst du nach einer zuverlässigen Backend-Architektur für ein AI-Dokument-Chat-System?
Was ich bauen kann
Ich kann bei Problemen wie folgendem Designen:
Sende mir deine Dokumententypen, erwartetes Seitenvolumen und bevorzugten Technologiestack, und ich helfe dir, die Backend-Pipeline zu planen.
Your AI System Built Right From Day One
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Kannst du einen Chatbot bauen, der Fragen aus meinen PDF-Dokumenten beantwortet?
Ja. Ich kann ein Dokument-Chat-System entwickeln, bei dem Nutzer PDFs hochladen und Fragen stellen, die anhand des Dokumentinhalts beantwortet werden.
Was, wenn meine PDFs gescannt sind und keinen auswählbaren Text haben?
Ich kann eine OCR-Pipeline hinzufügen, um Text aus gescannten und bildbasierten PDFs zu extrahieren, bevor sie für AI-Suche und Chat verarbeitet werden.
Mein AI-Chatbot gibt Antworten, die nicht wirklich in meinen Dokumenten stehen. Kannst du das beheben?
Ja. Ich kann eine RAG-Pipeline mit besserem Chunking, Retrieval, Metadaten und Quellenverankerung entwerfen, um unsupported answers zu reduzieren.
Kann der Chatbot mir zeigen, woher eine Antwort stammt?
Ja. Das System kann Quelleninformationen wie Dokumentname, Seitenzahl, Abschnitt oder extrahierten Text zusammen mit der Antwort zurückgeben.
Ich habe Tausende von Dokumenten. Können alle mit AI durchsuchbar sein?
Ja. Ich kann eine skalierbare Ingestions-, Embedding- und Vektor-Such-Architektur für große Dokumentensammlungen entwerfen.
Meine gescannten Dokumente enthalten Tabellen, Spalten oder ungewöhnliche Layouts. Funktioniert OCR trotzdem?
Solche Layouts können Extraktionsprobleme verursachen. Ich kann Vorverarbeitungs- und Validierungsschritte entwerfen, um häufige OCR-Fehlerquellen zu bewältigen und die Qualität der extrahierten Inhalte zu verbessern.
