Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Leitender Dateningenieur
Suchst du einen erfahrenen Data Engineer, der zuverlässige und skalierbare Datenpipelines erstellt?
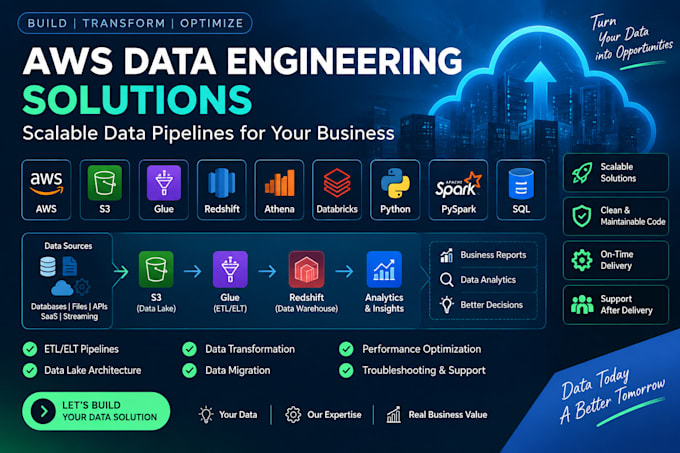
Ich entwickle und optimiere AWS Data Engineering, ETL/ELT und Datenverarbeitungs-Lösungen mit Python, Pyspark, SQL, AWS Glue, S3, Redshift, Athena und Databricks.
Wobei ich dir helfen kann:
Ich konzentriere mich darauf, saubere, skalierbare, wartbare und produktionsbereite Datenlösungen basierend auf deinen Geschäftsanforderungen zu erstellen.
Egal, ob du eine neue Datenpipeline brauchst, eine bestehende Arbeitsweise optimieren möchtest oder Hilfe bei der Fehlerbehebung deines Data Engineering Projekts benötigst – ich kann dir helfen.
Technologien: AWS | Python | Pyspark | SQL | Glue | S3 | Redshift | Athena | Databricks | Delta Lake
Expertise:
CI/CD
•
Monitoring & Logging
•
Automatisierungen
Cloud-Provider:
Amazon Web Services
