Kategorien durchsuchen
Deutsch
$
USD
Verbinden Sie sich mit Ihrer KI
Datenanalyse von einem Kollegen-Biologen
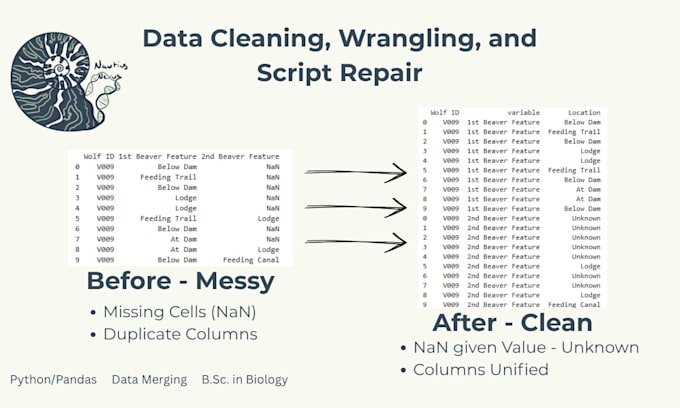
Bist du Grad student, Forscher oder Akademiker und kämpfst mit fehlerhaftem Code oder einem unordentlichen Datensatz? Als Datenanalyst mit einem B.S. in Biologie und einem Nebenfach in Psychologischer Wissenschaft verstehe ich, dass deine Daten Stunden akribischer Beobachtungen und körperlicher Arbeit repräsentieren und nicht bloß Unternehmens-Tabellen sind. Ich spezialisiere mich auf die mechanische Ausführung von Datenbereinigungen, damit du dich voll und ganz auf deine Thesis, Gremienrichtlinien oder andere dringliche Angelegenheiten konzentrieren kannst.
Was ich tue:
Code-Debugging: Syntaxfehler, Schleifen oder Layout-Warnungen in deinen Jupyter-Notebooks bereinigen.
Daten-Wrangling: Rohformate umstrukturiert, fehlende Zellen behandelt und Textkategorien normalisiert.
Multi-Stream-Integration: Bis zu 3 separate Logs oder Tabellen zu einem einheitlichen Datensatz zusammenführen.
Hinweis: Zum Schutz der Datenintegrität werden deine Rohdatei und Forschungsannahmen eingefroren, sobald der Auftrag beginnt.
Für große Datensätze, die die Basisschranken überschreiten, wähle bitte im Checkout den Extra Data oder File hinzu. Für ein zusätzliches Projekt-Notizbuch wähle denselben Betrag. Wenn du eine Erklärung des Codes möchtest, wähle 'Code Documentation'.
Sieh dir meinen öffentlichen Code unter github.com/skyegambrel an
Automatische Übersetzung
Welche Dateiformate akzeptierst du für die Bereinigung?
Ich akzeptiere Standard-Tabellendatenformate wie CSV, XLSX (Excel), TSV und TXT-Dateien sowie Jupyter-Notebook-Skriptdateien (.ipynb) zum Debuggen. Bitte stelle sicher, dass deine Dateistrukturen vor dem Upload nicht verschlüsselt sind.
Was zählt als ein einzelnes „Item Cleaned“ bzw. eine Dataset-Datei?
Ein einzelnes Item bezieht sich auf eine eigenständige Tabellenkalkulation, Datentabelle oder Quellcode-Notizbuch. Stufe 1 deckt eine einzelne fehlerhafte Skriptdatei ab, Stufe 2 eine einzelne Rohdatei (bis zu 200 Zeilen) und Stufe 3 das Bereinigen und strukturelle Zusammenführen von bis zu 3 Dateien.
Wie gehst du mit fehlenden Werten, leeren Zellen oder NaNs um?
• Ich nutze spezialisierte Python-Bibliotheken (Pandas und NumPy), um Muster fehlender Daten zu isolieren. Je nach deinen Anweisungen schreibe ich saubere Pipelines, um leere Zeilen zu entfernen, strukturelle Lücken zu isolieren oder fehlende Kategorien anhand deiner Projektanforderungen zu imputieren – ohne Fälschungen.
Wirst du den Python-Code oder die Bibliotheken erklären, die du zum Bereinigen verwendet hast?
Die Basistiers liefern die bereinigte Datendatei und dein annotiertes Skript. Wenn du eine umfassende, Zeile-für-Zeile-Erklärung auf einfachem Englisch der genauen Pandas-Funktionen brauchst, damit du die Datenpipeline deinem Ausschuss leicht verteidigen kannst, wähle bitte den Extra 'Code Documentation' beim Checkout.
Unterzeichnst du Geheimhaltungsvereinbarungen (NDAs) oder Datenschutzklauseln?
Gemäß den strengen, sicheren Plattformrichtlinien von Fiverr bleiben deine Rohdateien, Beobachtungsnotizen und Hypothesen vertraulich und Eigentum; sie werden niemals geteilt oder veröffentlicht.
