Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
KI- und Computer-Vision-Ingenieur, YOLO, Deep Learning, Python
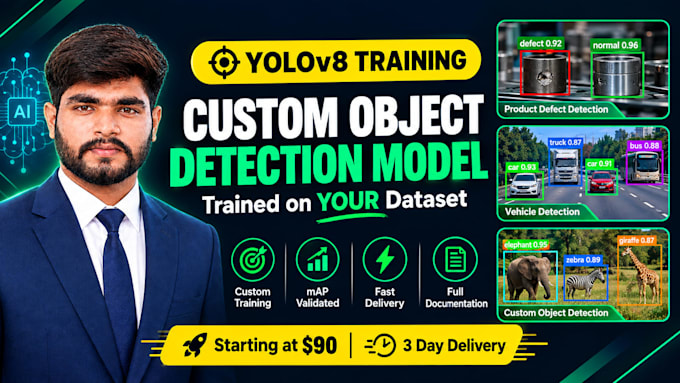
Hast du Schwierigkeiten, jemanden zu finden, der tatsächlich YOLO-Modelle trainiert, die in der Produktion funktionieren?
Ich trainiere maßgeschneiderte YOLO-Objekterkennungsmodelle auf deinem eigenen Datensatz mit validierter Genauigkeit, sauberem Code und vollständiger Dokumentation, schnell geliefert und einsatzbereit.
WAS ICH DEINEM MODELLE BEIBRINGE ZU ERKENNEN:
WAS DEIN PROJEKT ENTHÄLT:
PERFEKT FÜR:
Schreib mir vor der Bestellung, damit ich deinen Datensatz prüfen und den besten Ansatz bestätigen kann.

Automatische Übersetzung
Muss ich einen gelabelten Datensatz bereitstellen oder kannst du ihn für mich labeln?
Wenn dein Datensatz bereits im YOLO-, COCO- oder Pascal VOC-Format gelabelt ist, starten wir sofort mit dem Training. Wenn deine Bilder unlabeled sind, biete ich die Annotation als Zusatzservice an. Schreib mir mit deiner Bildanzahl, und ich gebe dir schnell ein Angebot für das Labeling.
Wie viele Bilder brauche ich für gute Genauigkeit?
Ja. Labeling ist als kostenpflichtiger Zusatz verfügbar. Für grundlegende Erkennung funktionieren mindestens 100-200 Bilder pro Klasse gut. Für größere Datensätze (über 500 Bilder) schlage ich einen phasenweisen Ansatz vor: labeln → trainieren → validieren → iterieren. Frag vorher nach einem ehrlichen Zeitplan und Kosten.
Welche YOLO-Version verwendest du für mein Projekt?
Ich nutze hauptsächlich YOLOv8, da es das beste Gleichgewicht zwischen Geschwindigkeit und Genauigkeit für die meisten Projekte bietet. Ich unterstütze aber auch YOLOv5, YOLOv9 und YOLOv10, je nach deinen spezifischen Anforderungen. Erwähne einfach deine Präferenz bei der Bestellung.
In welchem Format wird das trainierte Modell geliefert?
Du erhältst das Modell standardmäßig im PyTorch-Format (.pt). Auf Wunsch exportiere ich es auch in ONNX, TensorRT, TFLite oder CoreML für spezielle Einsatzumgebungen wie Mobile, Edge-Geräte oder Web-Anwendungen.
Besitze ich das trainierte Modell und den Quellcode?
Ja, komplett. Das volle Eigentum an den trainierten Modelgewichten, Trainingsskripten, Inferenzcode und aller Dokumentation geht bei der Lieferung an dich über. Es fallen keine Lizenzgebühren oder Einschränkungen an.
Ist mein Datensatz privat? Unterschreibst du NDAs?
Deine Daten werden nie geteilt oder gespeichert. Alle Dateien werden innerhalb von 7 Tagen nach Lieferung gelöscht. NDA ist im Premium-Paket enthalten, als Add-on auch bei Basic und Standard verfügbar.
Was, wenn die Genauigkeit meines Modells nicht zufriedenstellend ist?
Ich biete Revisionen in jedem Paket genau aus diesem Grund an. Wenn die Genauigkeit nach dem Training unter dem erwarteten Bereich liegt, retrainiere ich mit angepassten Hyperparametern, zusätzlicher Augmentation oder Architekturänderungen, bis wir die Zielperformance erreichen.
Woher weiß ich, welches Paket das richtige für mich ist?
Schreib mir zuerst. Sag mir, was erkannt werden soll, wie viele Bilder du hast und wo es läuft. Ich empfehle dir das passende Paket – kein Upselling.