Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
Pakistan
33 Aufträge abgeschlossen
Statistiker und Datenwissenschaftler, R Studio, Python und Maschinelles Lernen
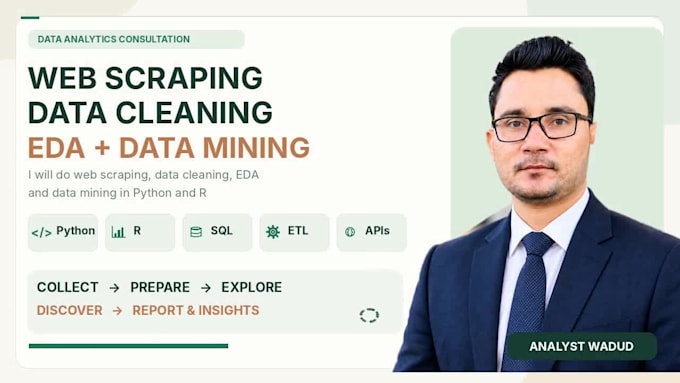
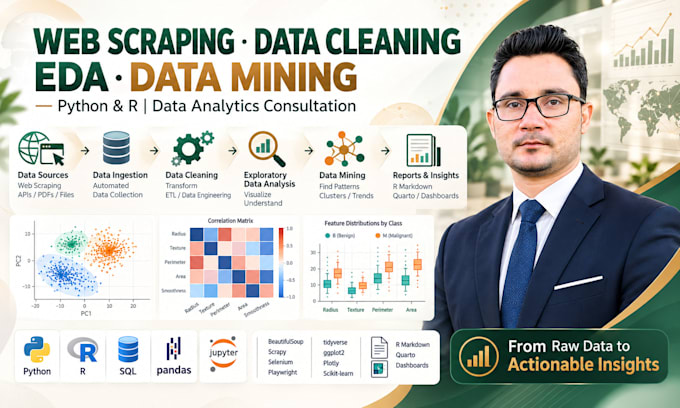
Möchtest du Daten sammeln, bereinigen, erkunden oder minen? Ich verwandle Webseiten, APIs und chaotische Dateien in analysereife Datensätze und umsetzbare Einsichten.
Ich bin Statistiker und Data Scientist mit mehr als 7 Jahren Erfahrung in R, Python und Forschungsanalytik.
Services (individuell auf dein Projekt zugeschnitten):
Tools umfassen Pandas, NumPy, tidyverse, scikit-learn, RStudio und SQL.
Packages decken Beratung, Datenaudit oder pilothafte Abgrenzung ab; komplette Pipelines, fortgeschrittene Modelle und wiederkehrendes Scraping werden über individuelle Angebote abgerechnet.
Schreib mir vorher eine Nachricht mit deinen Quellen, Beispieldaten, Zielen und gewünschtem Output. Nur autorisierte, erlaubte Daten verwenden.
Automatische Übersetzung
Kannst du Daten von Websites, APIs, PDFs oder Datenbanken sammeln?
Ja. Ich bewerte öffentlich zugängliche Websites, zulässige APIs, herunterladbare Dateien, PDFs und Datenbanken auf Extraktion. Web Crawling, Paginierung, geplanter Datenerfassung und größere Jobs werden nach Prüfung des Zugangs, der Quellenregeln und der Datenanforderungen offeriert.
Welche Web-Scraping- und Extraktionstools verwendest du?
Je nach Quelle: Python Requests, BeautifulSoup, Scrapy, Selenium, Playwright, APIs sowie R rvest und httr2. Ich kann strukturierte CSV-, Excel-, JSON- oder datenbankfertige Daten exportieren. Nur autorisierter, zulässiger Zugriff wird unterstützt.
Kannst du SQL-, ETL/ELT- und Data-Engineering-Pipelines aufbauen?
Ja, für vereinbarte Bereiche: Joins, Transformationen, Data Ingestion, Validierung, SQL-Abfragen und reproduzierbare ETL/ELT-Skripte. PostgreSQL, MySQL, SQLite, Pandas, dbt, Airflow, Spark oder Cloud-Warehouses können besprochen werden, wenn sie geeignet sind.
Kannst du unordentliche Datensätze bereinigen, zusammenführen und vorverarbeiten?
Ja. Ich gehe mit fehlenden Werten, Duplikaten, inkonsistenten Formaten, Datentypen, Ausreißern, Zusammenführungen, Umformen, Kodierung, Skalierung und Qualitätschecks mit Pandas, NumPy, tidyverse oder SQL vor. Der beste Ansatz hängt vom Datensatz ab.
Was ist in der explorativen Datenanalyse (EDA) enthalten?
EDA kann beschreibende Statistik, Verteilungen, Trends, Korrelationen, Heatmaps, Boxplots, Q-Q-Diagramme, Streudiagramm-Matrizen, Ausreißerprüfungen und Interpretation mit R, Python, ggplot2, seaborn, Matplotlib oder Plotly umfassen.
Kannst du Data Mining, KI- und Machine-Learning-Techniken anwenden?
Je nach Umfang: Segmentierung, K-Means, DBSCAN, Assoziationsregeln, Anomalieerkennung, PCA, Textmining/NLP, Regression, Klassifikation und Vorhersage. Fortgeschrittene Modelle, umfassendes Tuning und Deployment erfordern ein separates individuelles Angebot.
Welche Software, Programmierwerkzeuge und Pakete werden unterstützt?
Kernwerkzeuge: R/RStudio, Positron, Python, Jupyter, SQL, Excel, Pandas, NumPy, tidyverse, dplyr, ggplot2, scikit-learn und Quarto. SPSS, Stata, MATLAB, Power BI, Tableau, Shiny oder Streamlit können projektspezifisch besprochen werden.
Werde ich saubere Daten, Code, Diagramme, Dashboards oder Berichte erhalten?
Liefergegenstände können CSV, Excel, JSON, SQL/Parquet-Daten, R/Python-Skripte, Notebooks, reproduzierbare Berichte, statistische Tabellen, Visualisierungen und Dashboards umfassen. Genaue Dateien, Quellcode, Hosting und Tiefe des Berichts hängen vom individuellen Scope ab.
Warum bietest du Scoping-Pakete und individuelle Aufträge an?
Datenquellen, Volumen, Zugriffsbeschränkungen und Methoden unterscheiden sich stark. Basic deckt einen bezahlten Scope/ Machbarkeitsbewertung ab, Standard eine Prüfung und Premium einen limitierten Pilotversuch. Vollständiges Scraping, ETL-Pipelines, ML-Projekte, Dashboards und laufende Arbeiten nutzen individuelle Angebote.
Was soll ich bereitstellen und welche Extraktionsanfragen sind ausgeschlossen?
Sende Quell-URLs oder Beispieldateien, Autorisierungsdetails, benötigte Felder, ungefähres Volumen, Fragen, Ausgabeformat und Deadline. Es ist mir nicht möglich, Zugriffskontrollen zu umgehen, private Social Profiles zu scrapen oder persönliche Daten ohne Erlaubnis zu erheben.
| (1) | ||
| (0) | ||
| (0) | ||
| (0) | ||
| (0) |
ahil38

Pakistan
I had an outstanding experience working with Abdul Wadud on a complex dataset. Their thorough analysis and insightful visualizations through R Markdown provided meaningful insights, and their tailored approach and professionalism made the project a true success. Will absolutely come again and will recommend him.
50 $
Preis
1 Tag
Dauer
| (1) | ||
| (0) | ||
| (0) | ||
| (0) | ||
| (0) |
ahil38
Pakistan
I had an outstanding experience working with Abdul Wadud on a complex dataset. Their thorough analysis and insightful visualizations through R Markdown provided meaningful insights, and their tailored approach and professionalism made the project a true success. Will absolutely come again and will recommend him.
50 $
Preis
1 Tag
Dauer