Kategorien durchsuchen
Deutsch
$
USD
Deine KI mit Fiverr verbinden
KI-Entwickler, Machine Learning Engineer, Python FullStack Entwickler
Gereinigte Daten entscheiden darüber, wie weit ein Projekt kommt. Wenn Akten inkonsistent sind, Ordner unübersichtlich oder Bilder keine Labels haben, liegt das Problem nicht beim Algorithmus.
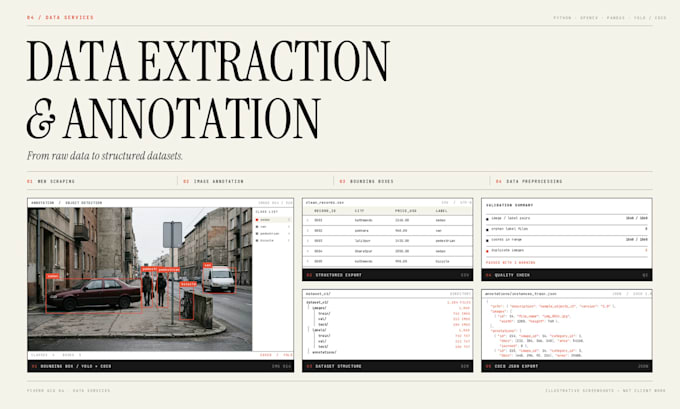
Ich sammle, labele, säubere und bereite Datensätze vor:
- Web Scraping: öffentlich verfügbare Daten in CSV, Excel oder JSON, mit Wörterbuch der Spalten
- Bildannotation: Klassifikations-Labels, Kategorien und konsistente Klassen-Definitionen
- Bounding Boxes: Objekt-Erkennungsannotation im YOLO- oder COCO-Format
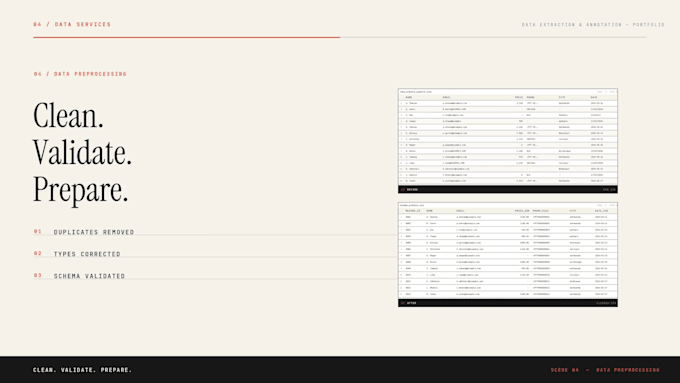
- Vorverarbeitung: Duplikate, fehlende Werte, Datentypen, Formatierung, Normalisierung
- Dataset-Vorbereitung: Ordnerstrukturen, Bild-Label-Paarungen, Aufteilungen, Validierung, Dokumentation
Tools: Python, Pandas, BeautifulSoup, Requests, Selenium/Playwright, OpenCV. Outputs: CSV, Excel, JSON, YOLO, COCO JSON, strukturierte Ordner.
Jede Lieferung enthält die verarbeiteten Dateien, eine Qualitätszusammenfassung und Hinweise darauf, was sich geändert hat. Originale bleiben erhalten.
Schreib mir vor der Bestellung eine Nachricht mit deiner Datenquelle, Menge, Klassen und gewünschtem Ausgabeformat, damit Scope und Preis zuerst festgelegt werden. Öffentlich zugängliche und erlaubte Quellen nur. Ich trainiere keine Modelle und baue keine Anwendungen im Rahmen dieses Gigs.


Automatische Übersetzung
Können Sie jede Website schaben?
Nein — und jeder Verkäufer, der Ja sagt, liegt falsch. Ich sammle aus öffentlichen Quellen, die du verwenden darfst, achte auf Ratenbeschränkungen und Nutzungsbedingungen. Seiten hinter Logins, Paywalls, CAPTCHAs oder Anti-Bot-Schutz fallen nicht darunter, und Seiten, die automatisierten Zugriff blockieren, können nach Prüfung abgelehnt werden.
Welche Dateiformate lieferst du?
CSV, Excel (XLSX), JSON, YOLO .txt-Dateien mit einer data.yaml, COCO JSON, organisierte Bildordner und Dokumentation in Markdown oder PDF. Ein Ausgabeformat ist in einem Paket enthalten; ein zweites Format derselben Daten wird als Extra angeboten.
Kannst du Bilder mit Bounding Boxes annotieren?
Ja. Ich annotiere Objekte nach einer vor Arbeitsbeginn vereinbarten Konvention: wie eng die Box dem Objekt folgt, ob teilweise sichtbare Objekte zählen, wie viele Boxen pro Bild, und wie Klassen benannt werden. Boxen können mit deiner Klassendefinition geliefert werden, exakt so, wie sie geschrieben steht.
Unterstützt du YOLO- und COCO-Formate?
Ja, beides — YOLO normalisierte .txt-Dateien mit einer data.yaml und COCO JSON mit Bildern, Annotationen und Kategorien. Ich kann auch zwischen ihnen konvertieren oder eine CSV der Pixelkoordinaten erzeugen, falls dein Pipeline das braucht.
Kannst du ein bestehendes Dataset reinigen und vorverarbeiten?
Ja. Dazu gehört Duplikate entfernen mit Zählung, Umgang mit fehlenden Werten nach deiner Vorgabe, Typ- und Datumskorrekturen, Leerzeichen- und Groß-/Kleinschreibung-Normalisierung, Spalten umbenennen, Bildgrößen anpassen und Validierung des Outputs. Originale bleiben erhalten und ein kurzer Transformationslog wird mit dem gereinigten Datensatz geliefert.
Können Bilder und Labels in Ordner organisiert werden?
Ja. Ich richte die Strukturen images/, labels/ und annotations/ ein, teile in train/validation/test wie vereinbart auf, prüfe, dass jedes Bild eine passende Label-Datei hat, melde verwaiste Dateien und gleiche Zählungen über die Aufteilungen ab.
Trainierst du Machine-Learning-Modelle?
Nicht in diesem Gig. Dieser Service endet beim Datensatz: Sammlung, Labels, Reinigung, Struktur und Dokumentation. Model-Training, Feintuning und Evaluation sind ein eigener Service — ein vorbereiteter Datensatz aus diesem Angebot kann diese Arbeit unterstützen, du zahlst dafür aber nicht in dieser Bestellung.
Können Sie mit großen Datensätzen umgehen?
Innerhalb der in jedem Paket genannten Mengen (bis zu 1.500 Datensätze oder 250 annotierte Bilder im Premium). Größere Mengen sind möglich, aber werden nach Einsicht des Musters separat angeboten, da der Annotierungsaufwand mit Bilder × Klassen × Objekte pro Bild skaliert, nicht nur mit der Dateigröße.
Wie wird die Annotierungsqualität geprüft?
Gegen Kriterien, die vor der Bestellung festgelegt werden: das Klassendefinitionsblatt, deine schriftlichen Anweisungen, ein vereinbarter Überprüfungsprozentsatz (zum Beispiel 10% der Bilder werden erneut geprüft) und die im Brief festgelegten Konventionen. Ambiguöse Fälle werden protokolliert, statt stillschweigend entschieden. Was ich nicht anbiete, ist eine pauschale Klärung.
Muss ich vor der Bestellung etwas schicken?
Ein kurzes Briefing: wofür die Daten dienen, wo sie liegen, wie viel es ist, die Klassennamen bei Annotation, und das benötigte Format. Screenshots einer bestehenden Annotation helfen sehr. Schick sie als Nachricht und du erhältst eine Scope-Notiz mit Menge, Format, Preis und Lieferzeit.