Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Daten- und Cloud-Ingenieur
Möchtest du, dass deine Daten automatisch gesammelt, bereinigt und aktuell gehalten werden? Ich baue Datenpipelines, die von selbst laufen, damit du immer frische, verlässliche Daten hast.
WAS ICH BAUE
- Extraktion aus APIs und Dateien mit Python
- Laden nach PostgreSQL
- Bereinigung und Modellierung mit dbt, inkl. Data-Quality-Tests
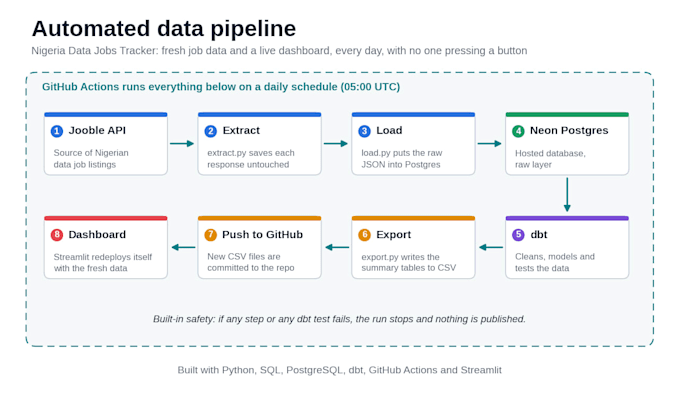
- Tägliche Automatisierung mit GitHub Actions, kein eigener Server nötig
- Ein Live-Streamlit-Dashboard, das du über einen Link öffnen kannst und das auch zu jeder gewünschten Endzieladresse führt
BEWEISE, DASS ES FUNKTIONIERT
Ich habe Nigeria Data Jobs Tracker aufgebaut und betrieben: Er zieht täglich Stellenanzeigen, bereinigt sie mit dbt und aktualisiert automatisch ein öffentliches Dashboard.
Live-Demo: nigeria-job-market-tracker-c2dqzraz9ouopa9qo4cgnt.streamlit.app
WIE ICH ARBEITE
- Du nennst mir deine Datenquelle und was du sehen möchtest
- Ich baue die Pipeline und übergebe dir den Code
- Tests laufen bei jedem Update, damit schlechte Daten schon vor dem Dashboard entdeckt werden
Tools: Python, SQL, PostgreSQL, dbt, GitHub Actions, Streamlit, Docker.
Schreibe mir vor der Bestellung eine kurze Beschreibung deiner Daten, dann empfehle ich dir das passende Paket.
Automatische Übersetzung
Was brauchst du von mir, um anzufangen?
Die Datenquelle (eine API, Dateien oder eine Datenbank), was du messen willst und wohin die Daten gelangen sollen.
Kann die Pipeline automatisch jeden Tag laufen?
Ja. Das Premium-Paket umfasst einen täglichen Zeitplan mit GitHub Actions, sodass es läuft, ohne dass jemand etwas starten muss.
Bekomme ich den Quellcode?
Ja, alle Pakete beinhalten den vollständigen Quellcode.