Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Dateningenieur
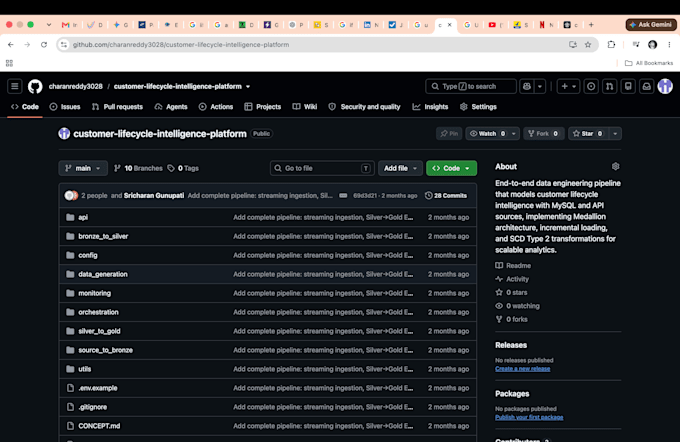
Ich baue zuverlässige und effiziente Datenpipelines mit Python, SQL, PySpark und modernen ETL-Workflows.
Egal, ob du CSV-, Excel-, JSON-, API- oder Datenbankdaten hast, ich kann dir beim Extrahieren, Bereinigen, Transformieren, Validieren und Vorbereiten für Analysen, Berichte oder nachgelagerte Anwendungen helfen.
Zu meinen Leistungen gehören:
Python-Datenverarbeitung und Automatisierung
SQL-Abfragen und Datenumwandlung
ETL-Pipeline-Entwicklung
PySpark-Datenverarbeitung
Datenbereinigung und Validierung
API- und dateibasierte Datenerfassung
Datenintegration von Datenbanken
Datenumwandlung und Workflow-Automatisierung
Grundlegende Pipeline-Dokumentation
Ich lege Wert auf sauberen, wartbaren und effizienten Code, der auf deine Anforderungen zugeschnitten ist.
Wenn du eine kleine Datenaufgabe, einen ETL-Workflow oder eine größere Datenpipeline hast, schick mir gern eine Nachricht mit deinen Anforderungen, bevor du eine Bestellung aufgibst. Ich prüfe dein Projekt und schlage die passendste Lösung vor.
Warehouse-Plattform:
BigQuery
Projektart:
Optimierung
