Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
LLM-Daten-Pipeline-Spezialist
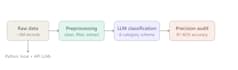
Benötigst du unstrukturierte Textdaten, die in saubere, gelabelte Kategorien umgewandelt werden sollen? Ich entwerfe und baue Klassifikationspipelines mit großen Sprachmodellen (lokal oder API-basiert) und Python, getestet bei einem Projekt mit etwa 3 Millionen Textdatensätzen.
Was ich anbiete:
- Maßgeschneiderte Textklassifikationsschemata, die auf deine Kategorien abgestimmt sind
- LLM-basierte Labeling (lokale Modelle wie Llama oder APIs wie DeepInfra/OpenAI)
- Python-Datenbereinigung und Vorverarbeitungs-Pipelines
- Genauigkeitsprüfung, damit du weißt, wie zuverlässig die Ergebnisse sind
- Klare Dokumentation von Methodik und Resultaten
Warum mit mir arbeiten:
Master-Forscher (Taipei Medical University, 4,0 GPA) mit praktischer Erfahrung im Aufbau und der Validierung von groß angelegten Klassifikationssystemen. Mir ist Genauigkeit wichtiger als Geschwindigkeit, deshalb enthält jede Pipeline, die ich erstelle, einen Validierungsschritt, damit du den Output vertrauen kannst.
Sende mir deine Daten und Kategorien, und ich finde den passenden Ansatz für dein Projekt.