Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
AI Engineer: LLM Agents, RAG, Document AI : Computer Vision und Video Analytics
Level 1
Hat bestimmte Leistungskriterien erfüllt und zeigt großes Potenzial auf dem Marktplatz.
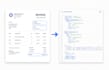
Geldest du noch immer jemanden, der Daten von Rechnungen, Quittungen, Ausweisen oder Formularen von Hand abtippt? Ich entwickle OCR- und Document AI-Systeme, die deine Dokumente lesen und saubere, strukturierte Daten direkt in deine Tabelle, Datenbank oder App zurückliefern.
Was ich extrahiere: Positionen auf Rechnungen & Quittungen, Summen, Daten, Ausweis- & KYC-Dokumente, Pässe, Führerscheine, Verträge & Formulare, Klauseln, Felder, Unterschriften, handgeschriebene & gescannte Dokumente
Jede Pipeline umfasst Felderkennung, Validierungsregeln zur Fehlererkennung, strukturiertes JSON/CSV-Output und einen Genauigkeitsbericht, damit du genau weißt, wie gut es funktioniert.
Stack: Python, PaddleOCR, Tesseract, AWS Textract, Google Document AI, Azure Form Recognizer, GPT-4 Vision. Ich wähle das passende Tool für deine Genauigkeit und dein Budget, keine Einheitslösung.
Weißt du nicht, ob es bei deinen Dokumenten funktioniert? Starte mit dem Proof of Concept, sende 3 bis 5 echte Dokumente und ich zeige dir die Extraktion auf DEINEN Daten, bevor du dich für eine vollständige Umsetzung entscheidest.
Schick mir eine Nachricht mit 2 bis 3 Beispiel-Dokumenten und den Feldern, die du brauchst, und ich sage dir genau, was möglich ist.


Programmiersprache:
Python
•
R
•
SQL
•
Colab
•
Amazon SageMaker
Frameworks:
scikit-learn
•
Google ML Kit
•
keras
•
PyTorch
•
Panda
Automatische Übersetzung
Funktioniert das auch bei meinen speziellen Dokumenten?
Fast immer — aber anstatt nur zu versprechen, beweise ich es. Schick mir 3–5 deiner echten Dokumente im Proof of Concept, und ich zeige dir die Extraktion auf deinen tatsächlichen Daten, bevor du dich für eine vollständige Umsetzung entscheidest.
Welche Genauigkeit kann ich erwarten?
Es hängt von der Qualität und dem Layout deiner Dokumente ab, deshalb nenne ich keine falsche Zahl im Voraus. Jeder Pipeline wird mit einem Genauigkeitsbericht geliefert (Präzision/Recall auf einem Testset deiner eigenen Dokumente), und ich optimiere, bis sie dein Ziel erreicht.
Bekomme ich den Quellcode und eine funktionierende API?
Ja bei Standard und Premium — beide beinhalten sauberen, dokumentierten Quellcode plus API-Integration, damit die Pipeline in dein System eingebunden werden kann. Das Basic Proof of Concept liefert Ergebnisse und eine Demo; du kannst den Quellcode auch als Extra hinzufügen, wenn du möchtest.
Meine Dokumente sind vertraulich — sind meine Daten sicher?
Absolut. Ich behandle jedes Dokument vertraulich, verwende deine Daten nie wieder und teile sie nicht. Gerne unterschreibe ich vor dem Versand sensibler Daten eine NDA.
Kannst du handschriftliche Texte oder Scans niedriger Qualität verarbeiten?
Ja — Handschrift, schiefe oder schlecht beleuchtete Fotos und unordentliche Scans, mit Vorverarbeitung und dem passenden Modell für den Job. Schick mir eine Probe, und ich sage dir ehrlich, was realistisch ist, bevor wir starten.
Ich bin mir nicht sicher, welches Paket ich brauche — wo fange ich an?
Schick mir einfach 2–3 Beispiel-Dokumente und die Felder, die du extrahieren möchtest. Ich schätze den Umfang ein und empfehle das passende Paket oder sende dir ein individuelles Angebot. Für die meisten neuen Projekte ist der Proof of Concept der klügste erste Schritt.


