Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Automatische Übersetzung
Bitte schreib mir vor der Bestellung eine Nachricht – sende ein Beispiel-Dokument, und ich bestätige, was möglich ist.
Immer noch Zahlen manuell aus PDFs abtippen? Rechnungen, Verträge, Ausschreibungsunterlagen, Finanzberichte: eine falsch gelesene Zahl kostet mehr als die gesamte Extraktion.
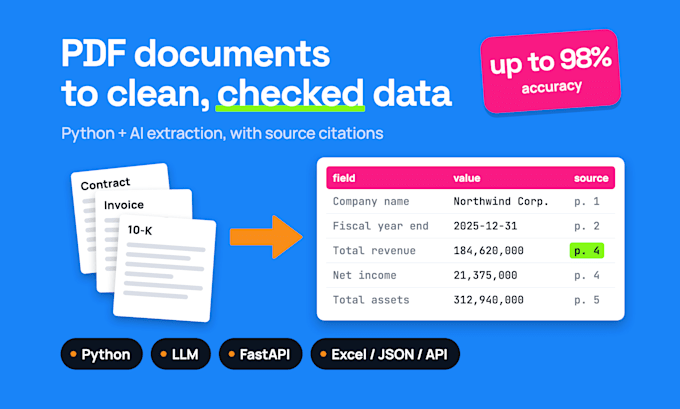
Ich erstelle Python-Pipelines, die deine Dokumente in saubere Tabellen umwandeln – und zeigen, woher jeder Wert stammt, damit du ihn überprüfen kannst, anstatt ihm zu vertrauen.
Was du bekommst:
Warum ich:
Kein passender Service für einmaliges Copy-Paste, das du auch mit ChatGPT erledigen kannst.
Schick mir eine Nachricht mit einem Beispiel-Dokument und was du daraus brauchst.
Python AI developer, over 12 years in IT, document AI and RAG in production
Sprachen
Automatische Übersetzung
Automatische Übersetzung
Warum sollten Sie mich wählen?
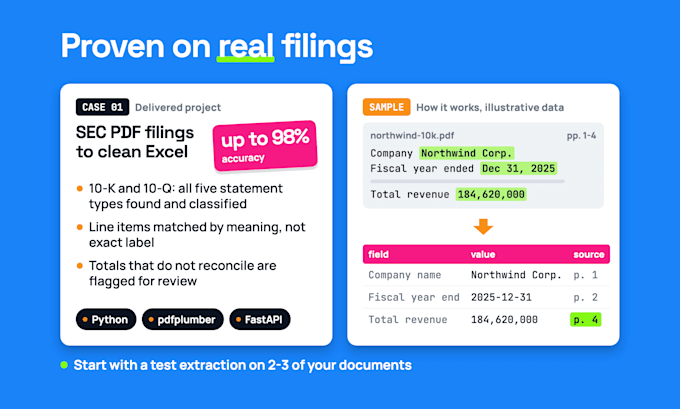
Ich erstelle eine Extraktion, die du überprüfen kannst: Jeder Wert bleibt auf seiner Quellseite, und Werte, bei denen das System unsicher ist, werden markiert, nicht geraten. Beweis: SEC 10-K/10-Q-Berichte, die mit bis zu 98 % Genauigkeit in Excel extrahiert wurden, 12+ Jahre Erfahrung in der IT.
Was ist inbegriffen?
Die Lieferungen im Paket, den Quellcode (inklusive Docker), einen Genauigkeitsbericht zu deinen eigenen Musterdokumenten und eine kurze schriftliche Übergabe.
Was ist nicht enthalten?
Manuelle Dateneingabe, Hosting-Kosten, LLM API-Gebühren und Dokumenttypen, die im Auftrag nicht vereinbart wurden. Zusätzliche Dokumenttypen können später als Extra hinzugefügt werden.
Sind meine Daten sicher?
Ja. Ich bin gerne bereit, deine NDA zu unterschreiben, bevor du Dokumente teilst. Ich verwende deine Dateien nur für diesen Auftrag und lösche sie nach Lieferung.
Kannst du vor der Bestellung des vollständigen Builds auf meinen eigenen Dokumenten testen?
Ja, dafür ist das Basic-Paket gedacht: Ich führe die Extraktion an 2-3 deiner eigenen Dokumente durch und sende einen Genauigkeitsbericht und einen Plan. Du entscheidest erst nach Sichtung der echten Zahlen über den vollständigen Build.
Wie genau wird es sein und wie misst du das?
Das hängt von deinen Dokumenten ab, deshalb messe ich es statt zu versprechen: Jeder extrahierte Wert wird mit dem korrekten Wert auf deinen Mustern verglichen, und du erhältst die Genauigkeit pro Feld im Bericht.
Verarbeitest du gescannte PDFs (OCR)?
Ja. Text-PDFs werden direkt gelesen; gescannte PDFs durchlaufen OCR. Die Scan-Qualität beeinflusst die Genauigkeit, deshalb werden gescannte PDFs im Basic-Paket zuerst an deinen eigenen Dateien getestet, bevor du dich für den vollständigen Build entscheidest.
Kannst du Tabellen aus PDFs extrahieren?
Ja. Tabellen sind das Herzstück meiner SEC 10-K/10-Q-Arbeiten (Finanzberichte). Jede Tabelle wird als Zeilen und Spalten in Excel, CSV oder JSON ausgegeben, wobei die Quellseite für jeden Wert erhalten bleibt.
Welche Ausgabeformate lieferst du?
Standardmäßig in Excel, CSV oder JSON. Mit dem Extra Export To Sheet & DB gehen die Daten direkt in dein Google Sheet oder deine Datenbank.
Kann es auf meinem eigenen Server laufen?
Ja. Das Premium-Paket wird in Docker geliefert, sodass die Pipeline auf deinem eigenen Server läuft und deine Dokumente bei dir bleiben.