Kategorien durchsuchen
Deutsch
$
USD
Verbinden Sie sich mit Ihrer KI
Data Scientist, KI-Ingenieur
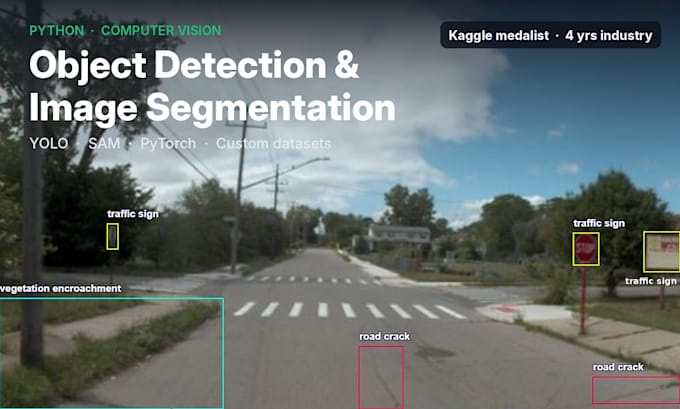
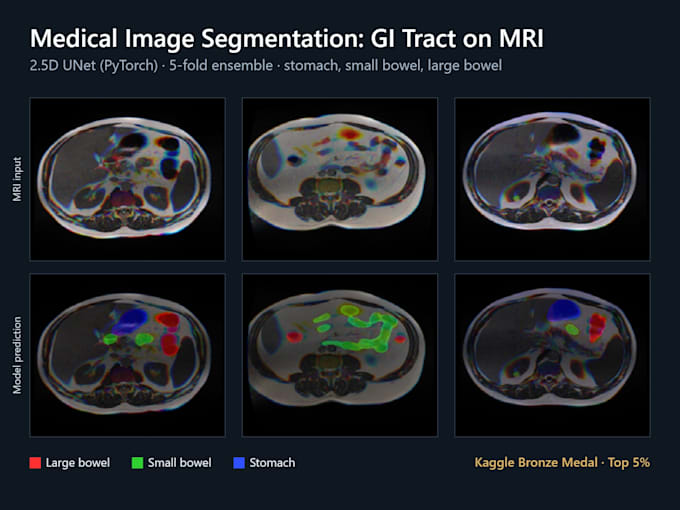
Brauchst du ein Computer-Vision-Modell, das mit deinen eigenen Bildern funktioniert? Ich trainiere, feine, optimiere und prüfe Objekterkennung und Bildsegmentierung in Python.
Was ich machen kann:
Warum ich:
So funktioniert es:
Die Ergebnisse hängen von der Datenqualität ab. Ich verspreche keine bestimmte Metrik, aber ich schildere genau, was erreicht wurde und warum.
Schreib mir bitte vor der Bestellung. Nicht enthalten: Daten-Labeling, Edge-Deployment, Echtzeit-Videosysteme.

Expertise:
Bildverarbeitung
•
Klassifizierung
•
Objekterkennung
Programmiersprache:
Python
•
Colab
•
MLflow
•
Amazon SageMaker
Tools:
Jupyter-Notizbuch
•
opencv
•
tensorflow
•
MLflow
•
CVAT
•
Colab
•
PyTorch
Frameworks:
scikit-learn
•
PyTorch
Automatische Übersetzung
Labelst du Daten?
Nein, es wird ein gelabelter Datensatz benötigt (YOLO, COCO oder Maskenformat). Ich berate gern zu Labeling-Tools und Label-Qualität.
Was bekomme ich?
Pipeline-Überprüfung: ein schriftlicher Bericht mit den Hauptfehlerursachen und einem Fix-Plan. Standard/Premium: Python-Code, trainierte Gewichte, ein Inferenz-Skript und Metriken. Premium fügt einen schriftlichen Bericht mit Fehlermustern hinzu.
Wie groß kann mein Datensatz sein?
Standard und Premium decken bis zu 2.000 beschriftete Bilder und 10 Klassen ab. Für größere Datensätze schick mir bitte eine Nachricht für ein individuelles Angebot.
Wo wird das Modell trainiert?
Auf meinem eigenem GPU-Rechner oder in deinem Google Colab- oder Cloud-Konto, wenn du die Daten dort behalten möchtest.