Kategorien durchsuchen
Deutsch
$
USD
Verbinden Sie sich mit Ihrer KI
Backend-Entwickler und Spezialist für lokale AI: Laravel, Python, RAG
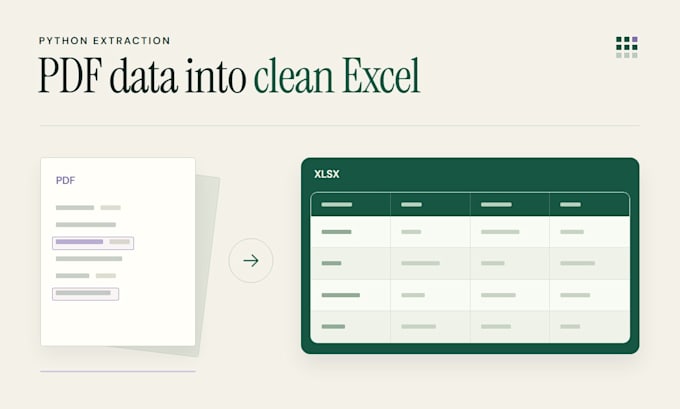
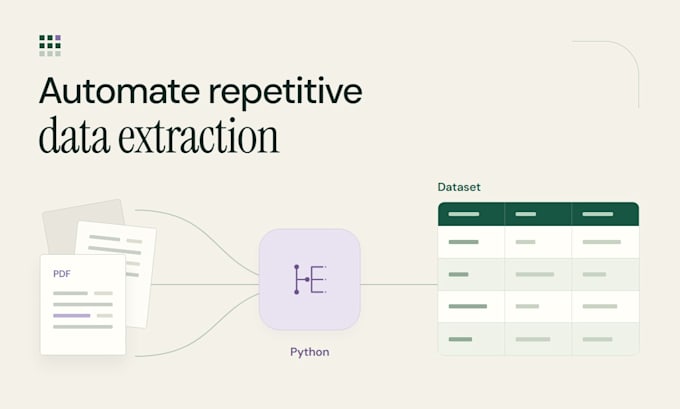
Verwandle wiederkehrende PDF-Berichte in eine saubere Excel- oder CSV-Datei, die du wirklich nutzen kannst.
Ich erstelle Python-Extraktions-Workflows für lesbare, textbasierte PDFs mit konsistenten Layouts. Du definierst die Spalten; ich ordne die vereinbarten Felder zu, verarbeite den enthaltenen Batch und prüfe die Output-Struktur.
Basis deckt bis zu 20 Seiten und ein Layout ab. Standard erweitert auf bis zu 70 Seiten, zwei Layouts und ein wiederverwendbares Python-Skript. Premium deckt bis zu 150 Seiten und drei Layouts ab, mit vereinbarten Validierungschecks und Laufdokumentation. Feld-, Datei- und Zeilenbegrenzungen gelten.
Du erhältst strukturiertes Output, eine kurze Extraktionszusammenfassung und eine klare Liste von Dingen, die überprüft werden müssen. Standard und Premium enthalten außerdem das Quellskript. Outputs werden gegen das vereinbarte Schema geprüft; eine PDF-Extraktion kann dennoch eine manuelle Prüfung erfordern.
Bitte schreibe mir vor der Bestellung eine redigierte Musterdatei jeder Layout-Variante und deine Zielspalten. Scans, Handschrift, fortgeschrittene OCR, Template-Änderungen und komplexe Geschäftsregeln benötigen eine separate Bewertung.
Technologie:
Excel
•
Google Sheets
•
Python
Automatische Übersetzung
Welche PDFs kannst du bearbeiten?
Lesbare, textbasierte PDFs mit einheitlichen Feldbezeichnungen oder Tabellenstrukturen passen am besten. Sende vor der Bestellung eine redigierte Musterdatei jedes Layouts, damit ich die Extraktion einschätzen und das Paket bestätigen kann.
Handelt es sich um manuelle Dateneingabe?
Der Service verwendet Python, um wiederholbare Datenstrukturen zu extrahieren. Er ist für wiederkehrende Dokumentformate mit definiertem Schema und geprüftem Output gedacht. Manuelle Transkription unterschiedlicher Dokumente ist nicht im Angebot enthalten
Was zählt als unterschiedliches Layout?
Ein Layout verwendet dieselben Feldbezeichnungen, -positionen und Tabellenstruktur. Verschiedene Werte oder Daten sind in der Regel OK. Eine geänderte Kopfzeile, ein verschobenes Feld oder eine neue Tabellenanordnung können eine separate Extraktionslogik erfordern und gelten als ein weiteres Layout.
Wird das Ergebnis zu 100% korrekt sein?
Es wird kein Genauigkeitsprozentsatz garantiert. Ich prüfe repräsentative Outputs, kontrolliere das vereinbarte Schema und kennzeichne erkannte Ausnahmen. PDFs können fehlenden Text oder ungewöhnliche Formatierungen enthalten, daher solltest du markierte Werte vor der Nutzung der Daten prüfen
Kannst du gescannte PDFs oder Handschrift verarbeiten?
Scans, bildbasierte PDFs, Handschrift, fortgeschrittene OCR und Dokumente schlechter Qualität benötigen eine gesonderte Bewertung und ein maßgeschneidertes Angebot. Sie sind nicht in diesen Paketen enthalten.