Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Dateningenieur
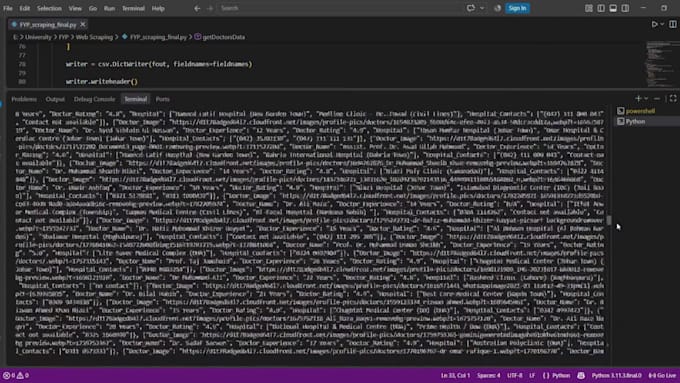
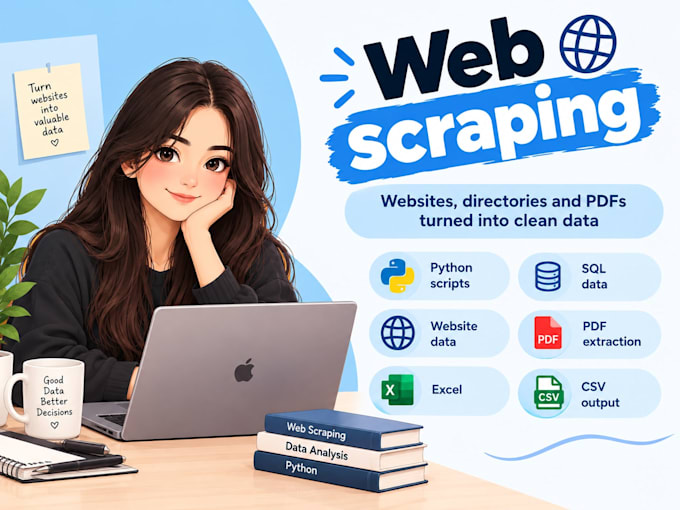
Ich extrahiere Daten von statischen Websites mit Python und liefere sie in einem sauberen, einsatzbereiten Format wie CSV, JSON oder PDF, je nachdem, was für dich am besten passt.
Womit ich arbeite:
Wichtig, bitte vor Bestellung lesen:
Ich arbeite nur mit statischen Websites (Seiten, bei denen die Daten direkt im HTML der Seite geladen werden). Ich bearbeite derzeit keine Seiten, die Browser-Automatisierung oder umfangreiches JavaScript-Rendering benötigen, um Inhalte zu laden (z.B. unendliches Scrollen, Login-geschützte Dashboards oder Daten, die erst nach Klicks oder Interaktionen sichtbar werden). Wenn du dir unsicher bist, ob deine Zielseite statisch ist, schick mir vor der Bestellung die URL, und ich bestätige das schnell, um Zeitverschwendung auf beiden Seiten zu vermeiden.
Was du bekommst:



Technologie:
Python
•
Excel
•
scrapy
•
Beautiful Soup
•
Andere
Technik:
Automatisiert
Automatische Übersetzung
Kannst du die Daten auch als PDF statt als Tabelle liefern?
Ja, ich kann deine gescrapten Daten in einen sauberen PDF-Bericht umwandeln.
Was, wenn die Seite Login oder Interaktion braucht, um Daten zu laden?
Ich informiere dich vor Beginn, damit wir die Optionen besprechen können — ich nehme keine Arbeit an, die ich nicht gut liefern kann.
Kannst du JavaScript-intensive oder dynamische Websites scrapen?
Derzeit nicht, ich spezialisiere mich auf statische Websites. Schick mir zuerst die URL, dann bestätige ich, ob es passt.