Kategorien durchsuchen
Entdecken
Fiverr Pro
Deutsch
$
USD
Python Web Scraping und Data Automation Spezialist
Verwandle Webseiten-Daten in einen sauberen, nutzbaren Datensatz. Ich verwende Python, Scrapy, Selenium, Beautiful Soup und Pandas für Web-Scraping, Datenextraktion und strukturierte Lieferung.
BASIS: 1 Quelle, bis zu 100 Seiten.
STANDARD: bis zu 2 Quellen und 200 Seiten, mit Bereinigung und Dublettentfernung.
PREMIUM: bis zu 3 Quellen und 300 Seiten, mit Matching und Normalisierung.
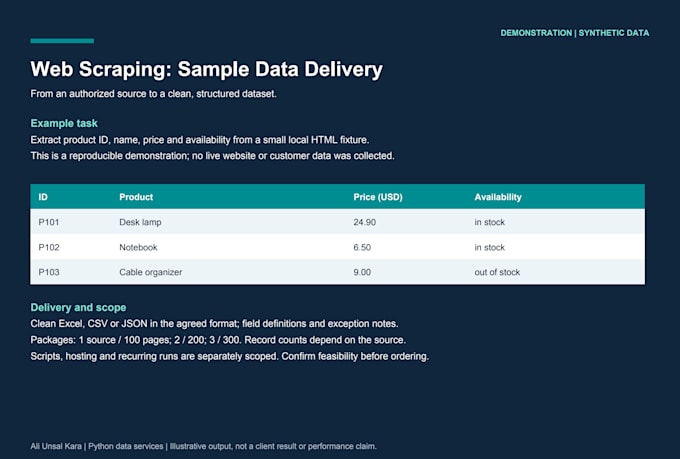
Alle Pakete enthalten einen bereinigten Excel-, CSV- oder JSON-Datensatz in deinem gewählten Format. Überarbeitungen decken Korrekturen innerhalb der vereinbarten Quellen und Felder ab.
Bitte schreibe mir vor der Bestellung mit den Quellen-URLs, benötigten Feldern, einem Muster-Ausgabe und dem erwarteten Volumen. Ich prüfe die Machbarkeit und bestätige den Umfang. Dynamische Seiten, Paginierung und API-Sammlung können vor einer Bestellung geprüft werden.
Dieser Service deckt öffentlich zugängliche oder autorisierte Daten ab. CAPTCHA-Umgehung, Umgehung von Zugriffsbarrieren, bezahlter Datenzugang, laufende Hosting-Dienste und wiederkehrende Durchläufe sind nicht enthalten. Ein wiederverwendbares Skript oder eine API-Integration erfordert einen separat vereinbarten Umfang.
Organisierte Daten bereit für Analyse, Recherche oder Import.

Technologie:
Python
•
scrapy
•
Selen
•
Beautiful Soup
•
Pandas
Informationstyp:
Notierungen
•
Websites
Technik:
Automatisiert
Automatische Übersetzung
Was benötigen Sie, bevor ich bestelle?
Sende die Quellen-URLs, benötigte Felder, erwartetes Volumen, bevorzugtes Excel/CSV/JSON-Format und eine Muster-Ausgabe. Schreibe mir bitte zuerst, damit ich Zugriff, Komplexität und Machbarkeit prüfen kann, bevor du bestellst.
Erhalte ich einen Datensatz oder ein wiederverwendbares Skript?
Pakete enthalten einen bereinigten Datensatz in dem von dir gewählten Excel-, CSV- oder JSON-Format. Ein wiederverwendbares Python-Skript, Deployment, API-Integration oder wiederkehrende Automatisierung erfordern einen separat vereinbarten Umfang.
Kannst du mit dynamischen Websites und APIs umgehen?
Ich verwende Selenium, Scrapy, Beautiful Soup und Python-Tools. Dynamische Inhalte, Paginierung und API-Zugriff müssen vor der Bestellung geprüft werden. CAPTCHA-Umgehung oder Zugriffsrestriktionen wird nicht vorgenommen.
Was gilt als Seite und Revision?
Eine Seite entspricht einer Quellen-URL oder einer Pagination/API-Ergebnissseite. Aufzeichnungsanzahl variiert je Quelle. Überarbeitungen korrigieren das vereinbarte Output innerhalb der Originalfelder und -quellen; neue Quellen, zusätzliche Felder oder wiederkehrende Durchläufe benötigen einen neuen Umfang.